データ利活用初学者向け 仮説検証実践フレームワークの提案と有効性検証
※本稿の著作権は,(株)アシストに帰属します.
1.序論
1.1 研究テーマ
本稿の課題は,データ分析を専門としない業務従事者が,自身の業務の中でデータを利活用し,仮説検証を実践できるスキルを獲得するためのフレームワークを提供することである.これにより,企業内でデータ利活用を担える人材層を広げ,結果として人材不足の緩和に寄与することを目指す.
筆者らは,このフレームワークを具現化する教材として「データ利活用トレーニングブック(以後,トレーニングブック)」を開発し,その有効性を検証した.
1.2 研究背景
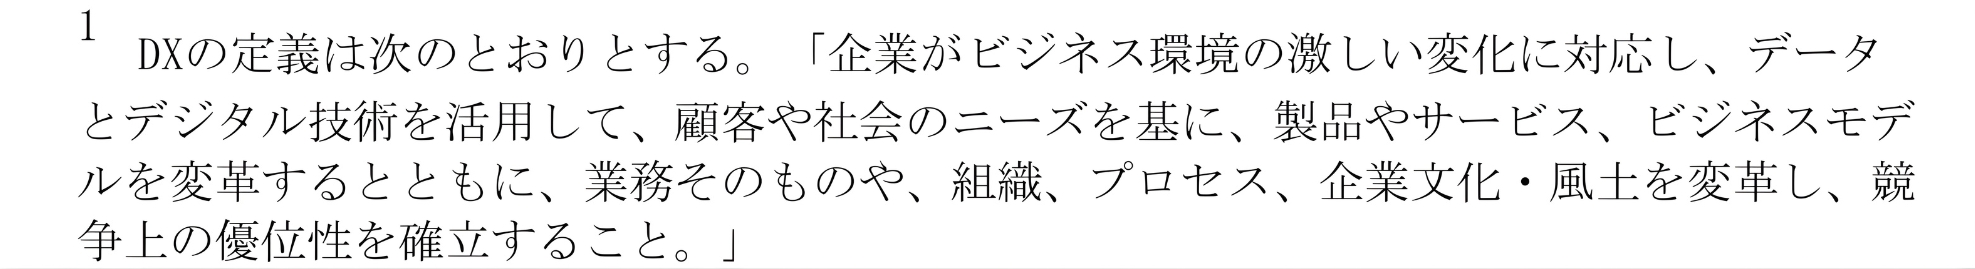
近年,デジタルトランスフォーメーション(DX)[1]の推進は企業の競争優位性を確立するための不可欠な要素であり,その成否はデータとデジタル技術の活用にかかっている(図1[1]).
しかしながら,IPA「DX動向2025」の「データ整備・管理・流通の課題」に関する調査結果(図2[2])によれば,日本企業において「人材の確保が難しい」との回答が58.2%と最も高く,他国と比較しても突出している[2].
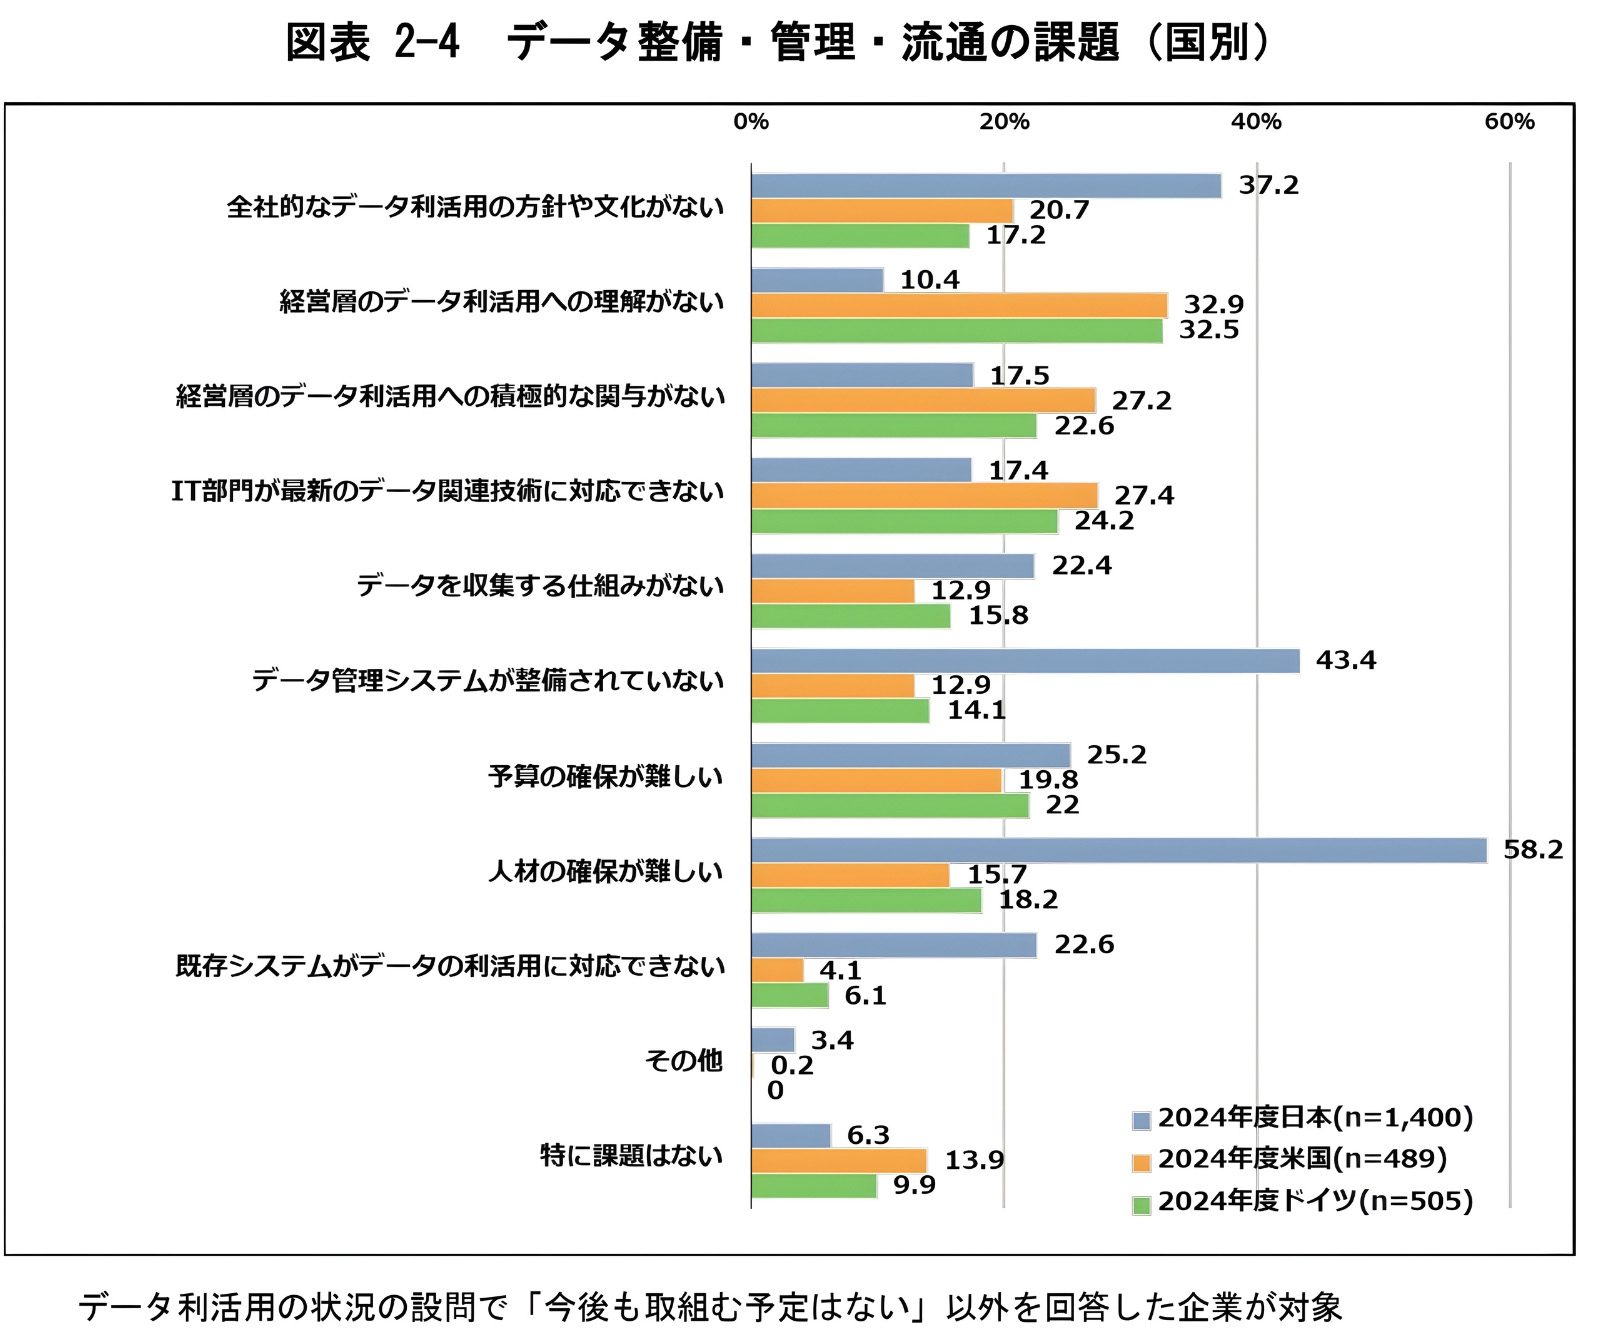
このことから,データ利活用人材の不足は,単なる人数不足の問題にとどまらず,DX推進に不可欠な現場でのデータ活用・実践を妨げる深刻な障壁となっており,喫緊に解決すべき課題であることが明確である.
1.3 研究の意義,必要性,重要性
データ利活用の必要性が叫ばれる一方で,現場の実務者,特にデータ分析を専門としない初学者にとっては,その実践へのハードルが高いのが現状である.既存の学習リソース(専門書やWebサイトなど)は,データサイエンスや機械学習といった技術的側面に焦点を当てたものが多く,以下の本質的な課題を有する.
- 難解性
内容が専門的すぎるため,初学者にとっては理解や実践のハードルが高い.
- 本質的な視点の欠如
分析手法や可視化テクニックに終始し,「なぜデータを活用するのか」という本質的な問い,すなわちビジネス課題との結びつきが見えにくい.
これらの課題により,客観的データに基づいて意思決定を試みる実務者であっても,その過程に不安を抱えてしまう実態がある.この状況は,本研究の事前アンケート調査(図3)によっても確認されている.
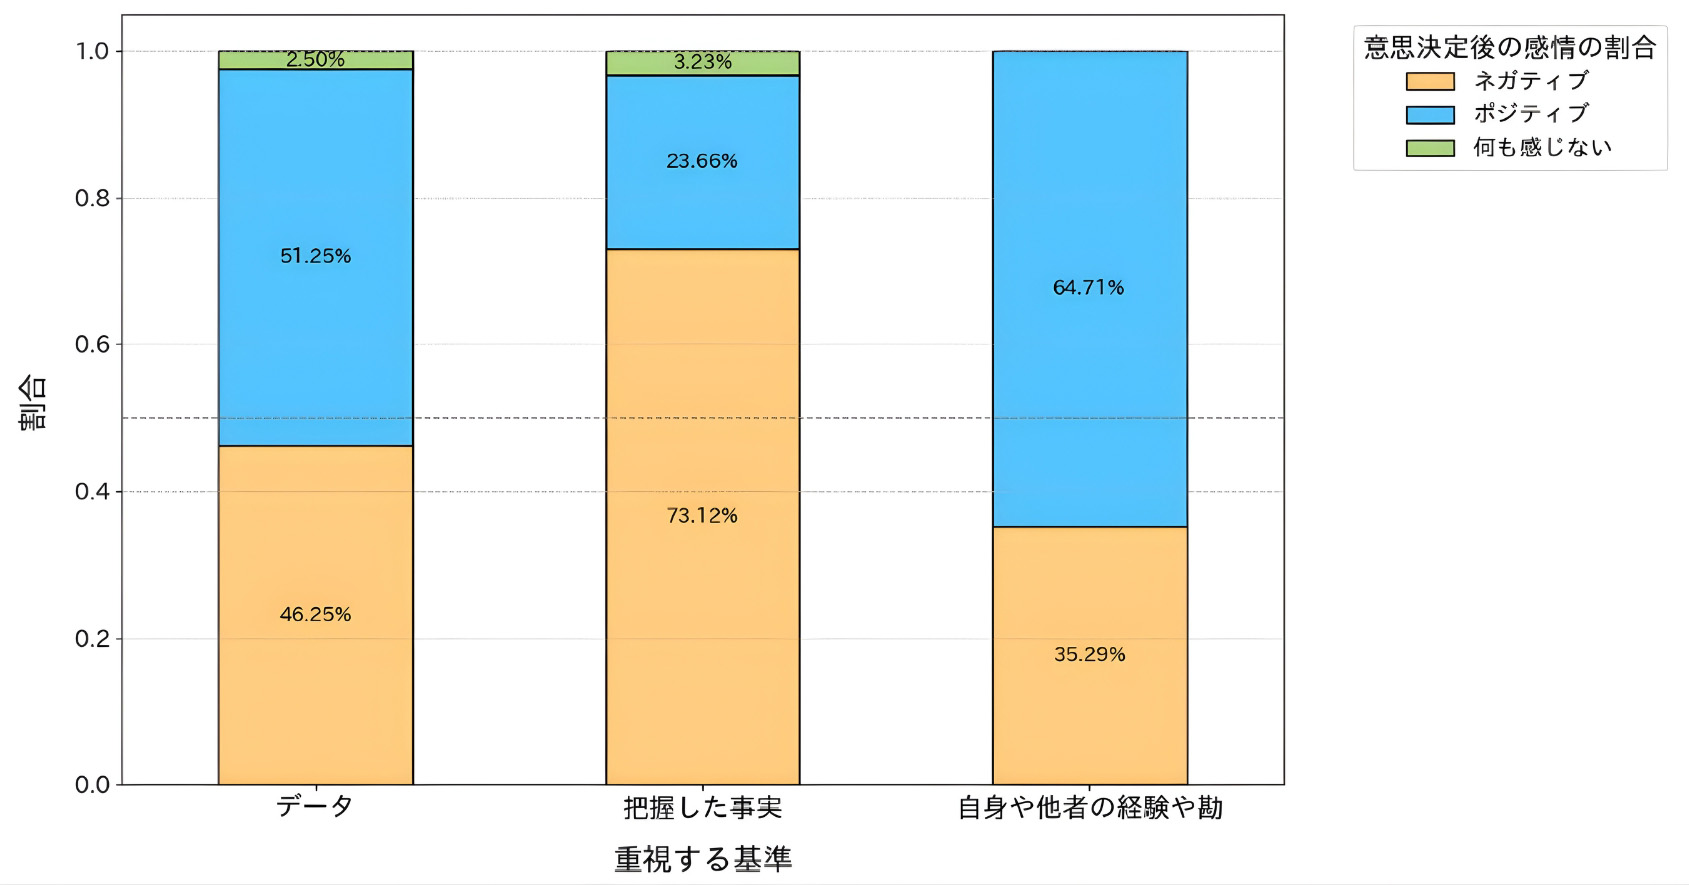
※「やや不安」「不安」をネガティブ,「まぁ心配ない」「心配ない」をポジティブと表現している.
※ソリューション研究会関係者を対象としたアンケート調査を実施.アンケートには213名から回答を得た.
特に本質的な視点の欠如からビジネス課題に対する仮説設定が甘くなり,「そもそも何が問題で,何を検証したいのか」というデータ利活用の土台が不明瞭となるため,導かれたデータ分析の結果(意思決定の根拠)に対しても確信が持てず,その結果をポジティブに捉えられない状態が,心理的な「不安」となって表れていると考えられる.
これは,データ活用の「手段」ばかりに意識が向き,データ利活用のプロセスにおける最初の工程である「問題」の設定,すなわち「データ利活用に必要不可欠な仮説構築のプロセス」が適切に行えていない可能性を示唆している.
1.4 当テーマの既存対策
データ利活用に関する従来の主な学習手法は,データサイエンティスト協会「データサイエンティストの就労意識(2024年)」調査(図4[3])によると,「インターネット・雑誌等での情報収集」(72%),「専門的な書籍を購入しての業務外での学習」(66%)が主要であった[3].
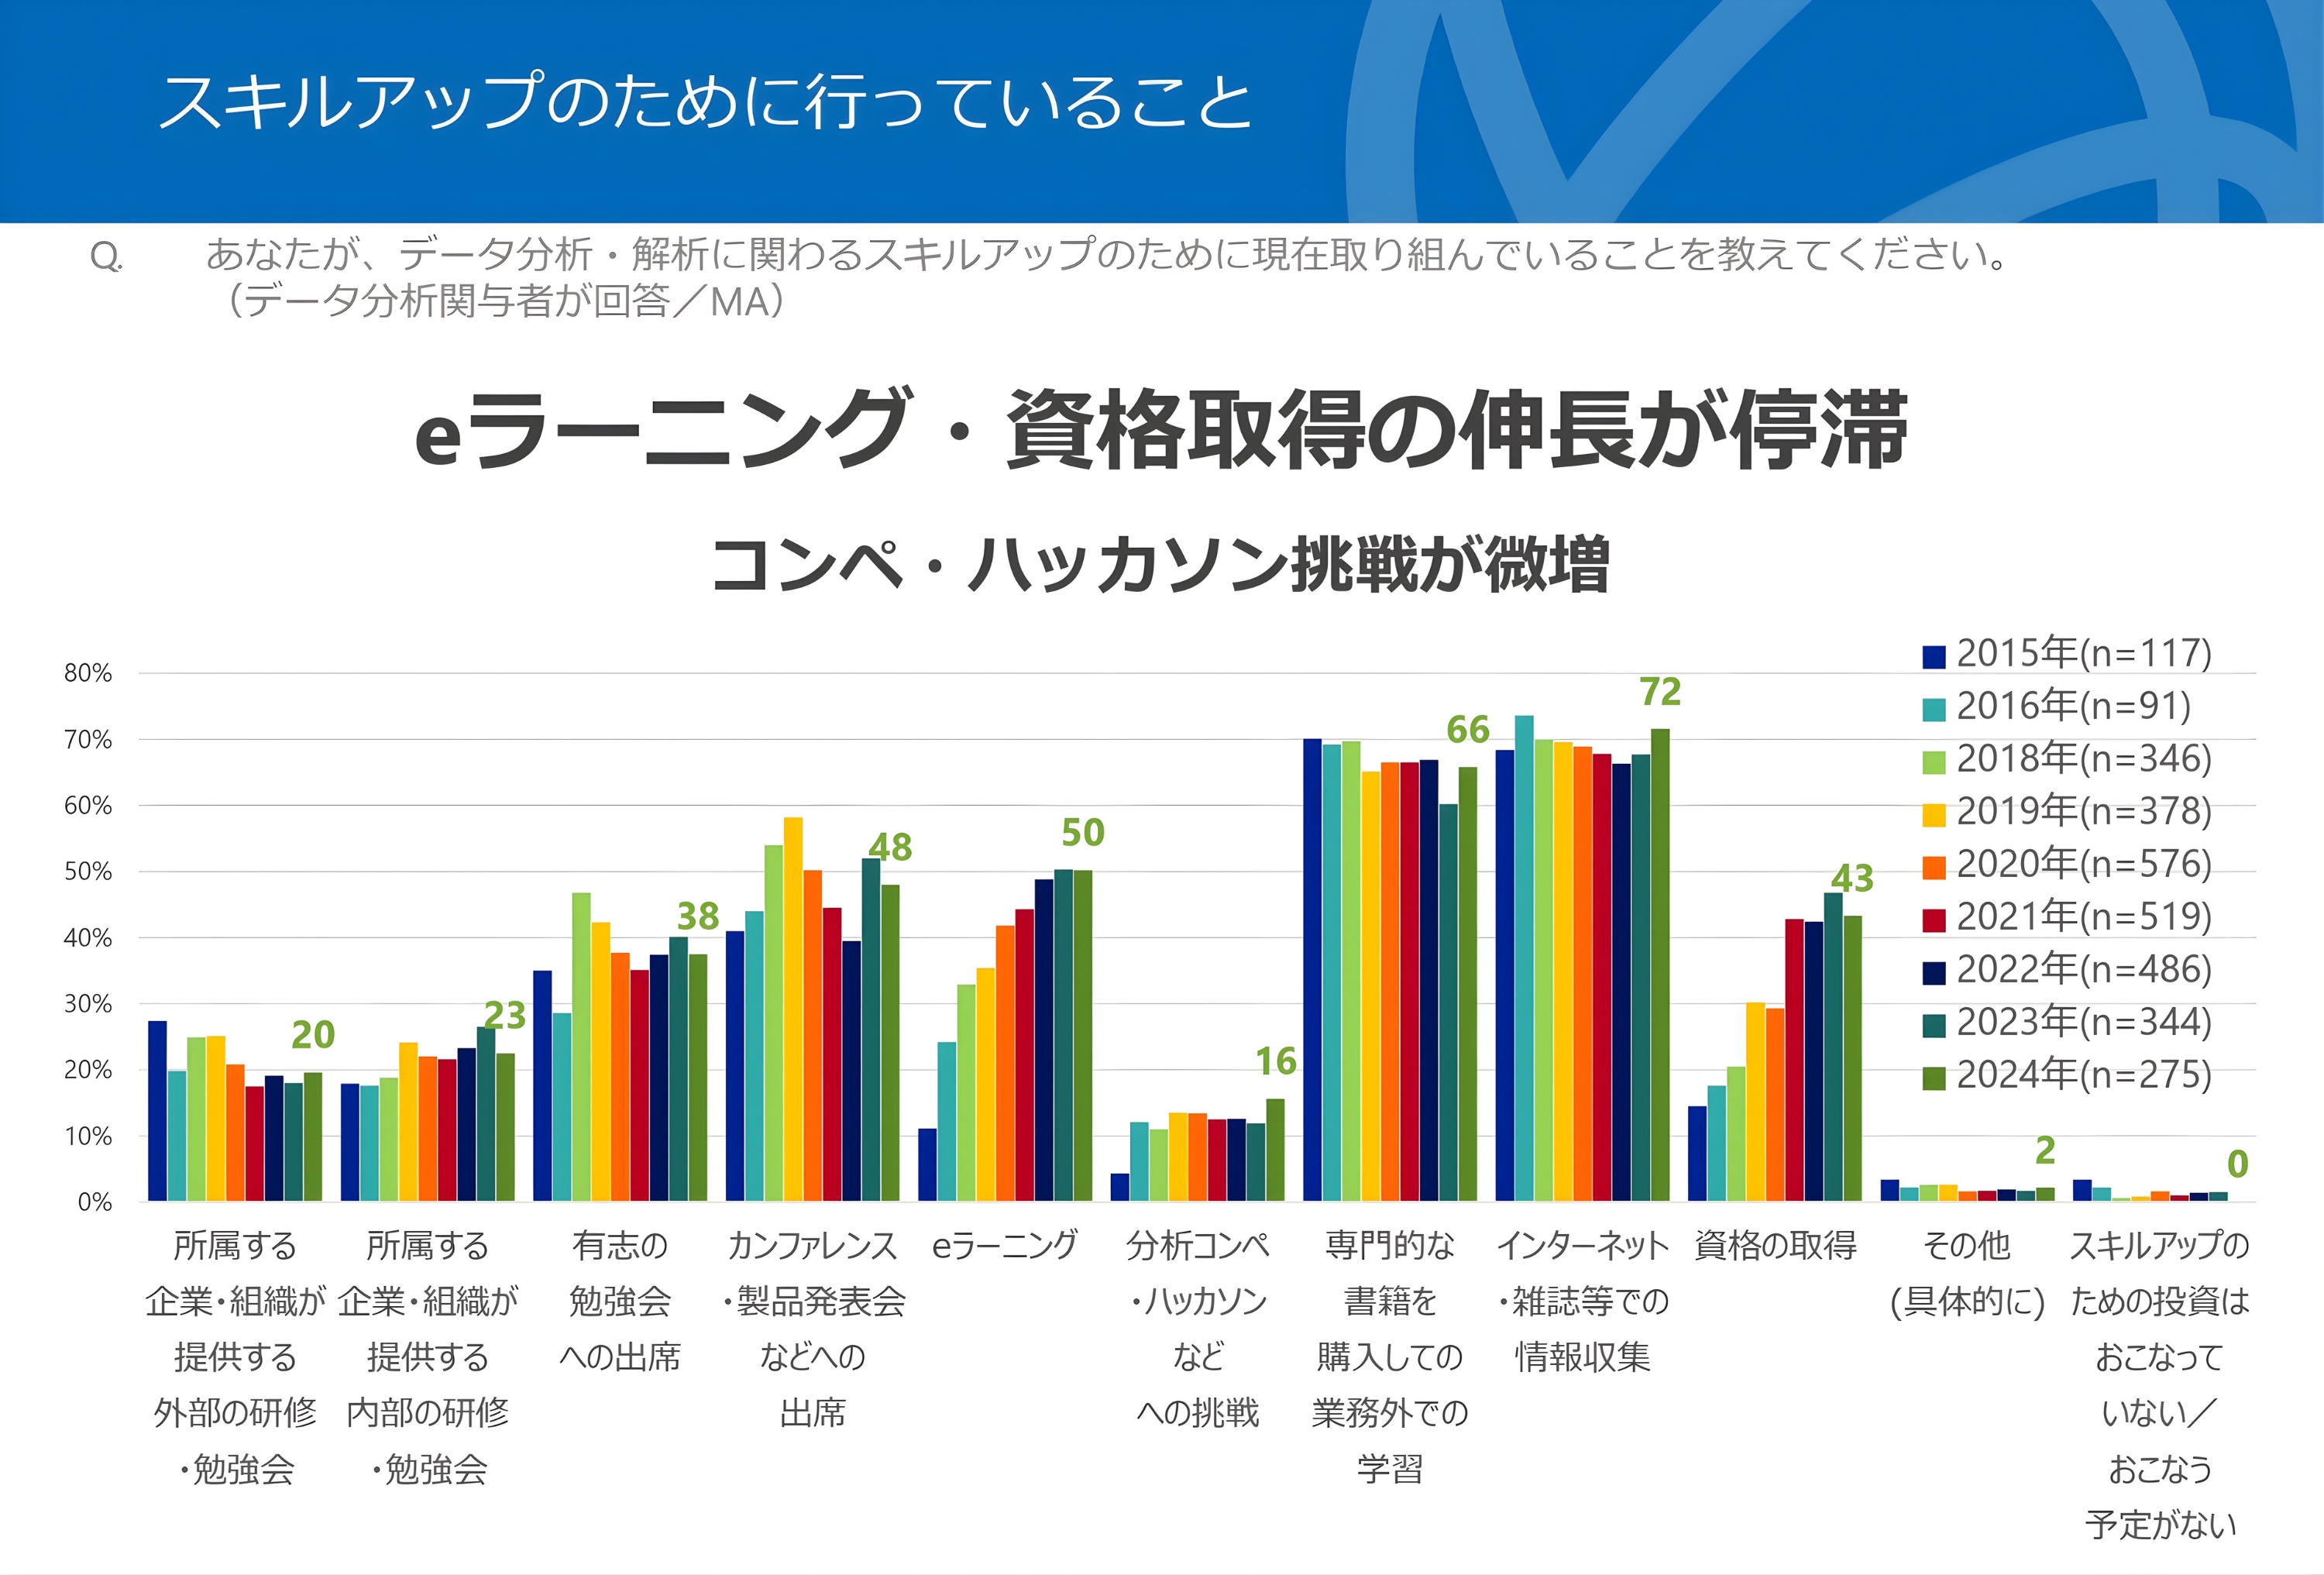
これらの結果や,一般的な取り組みを総合すると,従来の対策は,イベントや媒体を通じた知識・知見の獲得と,OJT(On-the-Job Training)などによる実務上の実践を主な内容としていたといえる.
1.5 既存対策の欠点
この対策には次の3点の問題・盲点があった.
- 媒体・イベントにおける内容の専門性
統計学の理論や高度なデータ分析技術に主に焦点が当たっており,内容が専門的すぎるため,初学者にとっては理解や実践のハードルが高い.これは,既存の媒体がデータ分析の基礎理論を学習したい学生や理論学習者,あるいはすでにデータ分析の実務を行っており高度な技術習得を目的とする専門家層を主な対象としている傾向が見られるためである.その結果,自身の業務の中でデータを利活用したい初学者のニーズとは合致しない場合が多い.これは,第1.3節で指摘した「難解性」の課題と本質的に同一である.
- イベントにおける個別対応の難しさ
イベントでは,難易度や取り扱う事例・データが,初学者一人ひとりの状況に合致しているかどうかを,受講前に判断するのが難しい.
- OJTにおける指導体制の不足
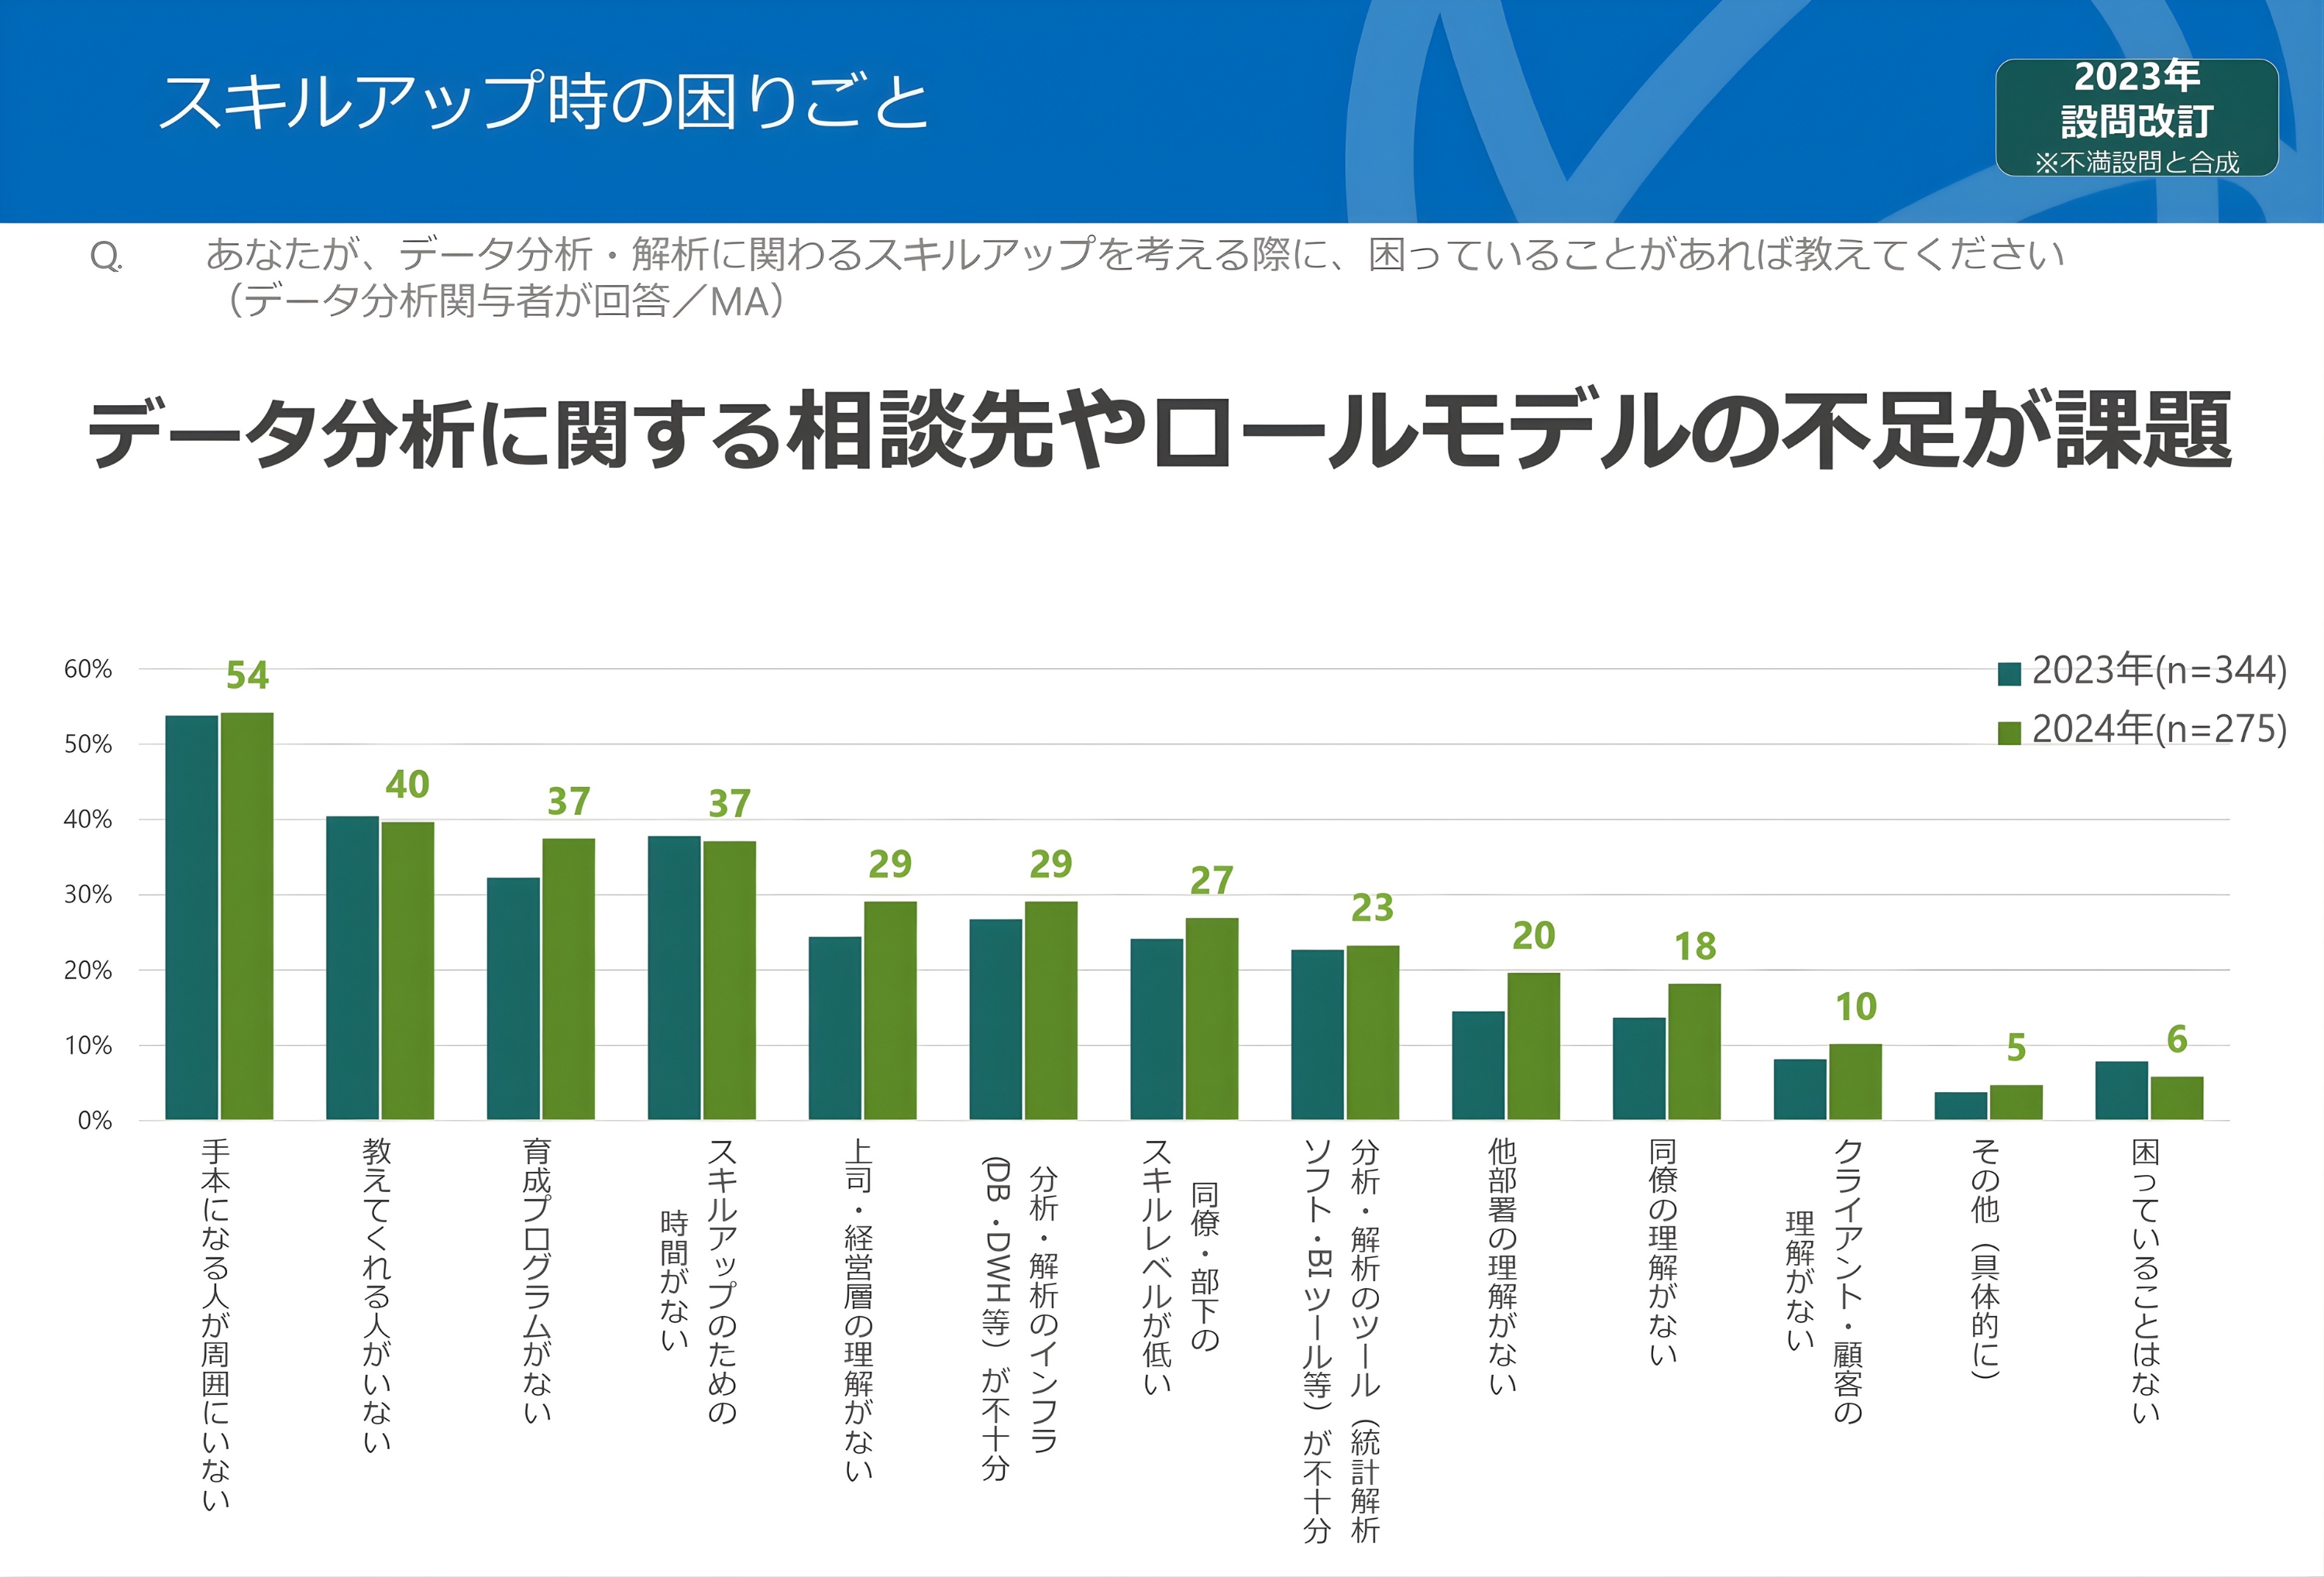
OJTなどの実務上の実践においては,自身の業務を行う際に,身近にデータ分析に関して相談できる人がいないことが多い.実際,データサイエンティスト協会の調査(図5[3])では,スキルアップ時の困りごととして「手本になる人が周囲にいない」(54%),「教えてくれる人がいない」(40%)との回答が多数を占めており[3],指導体制の不足が明確に示されている.
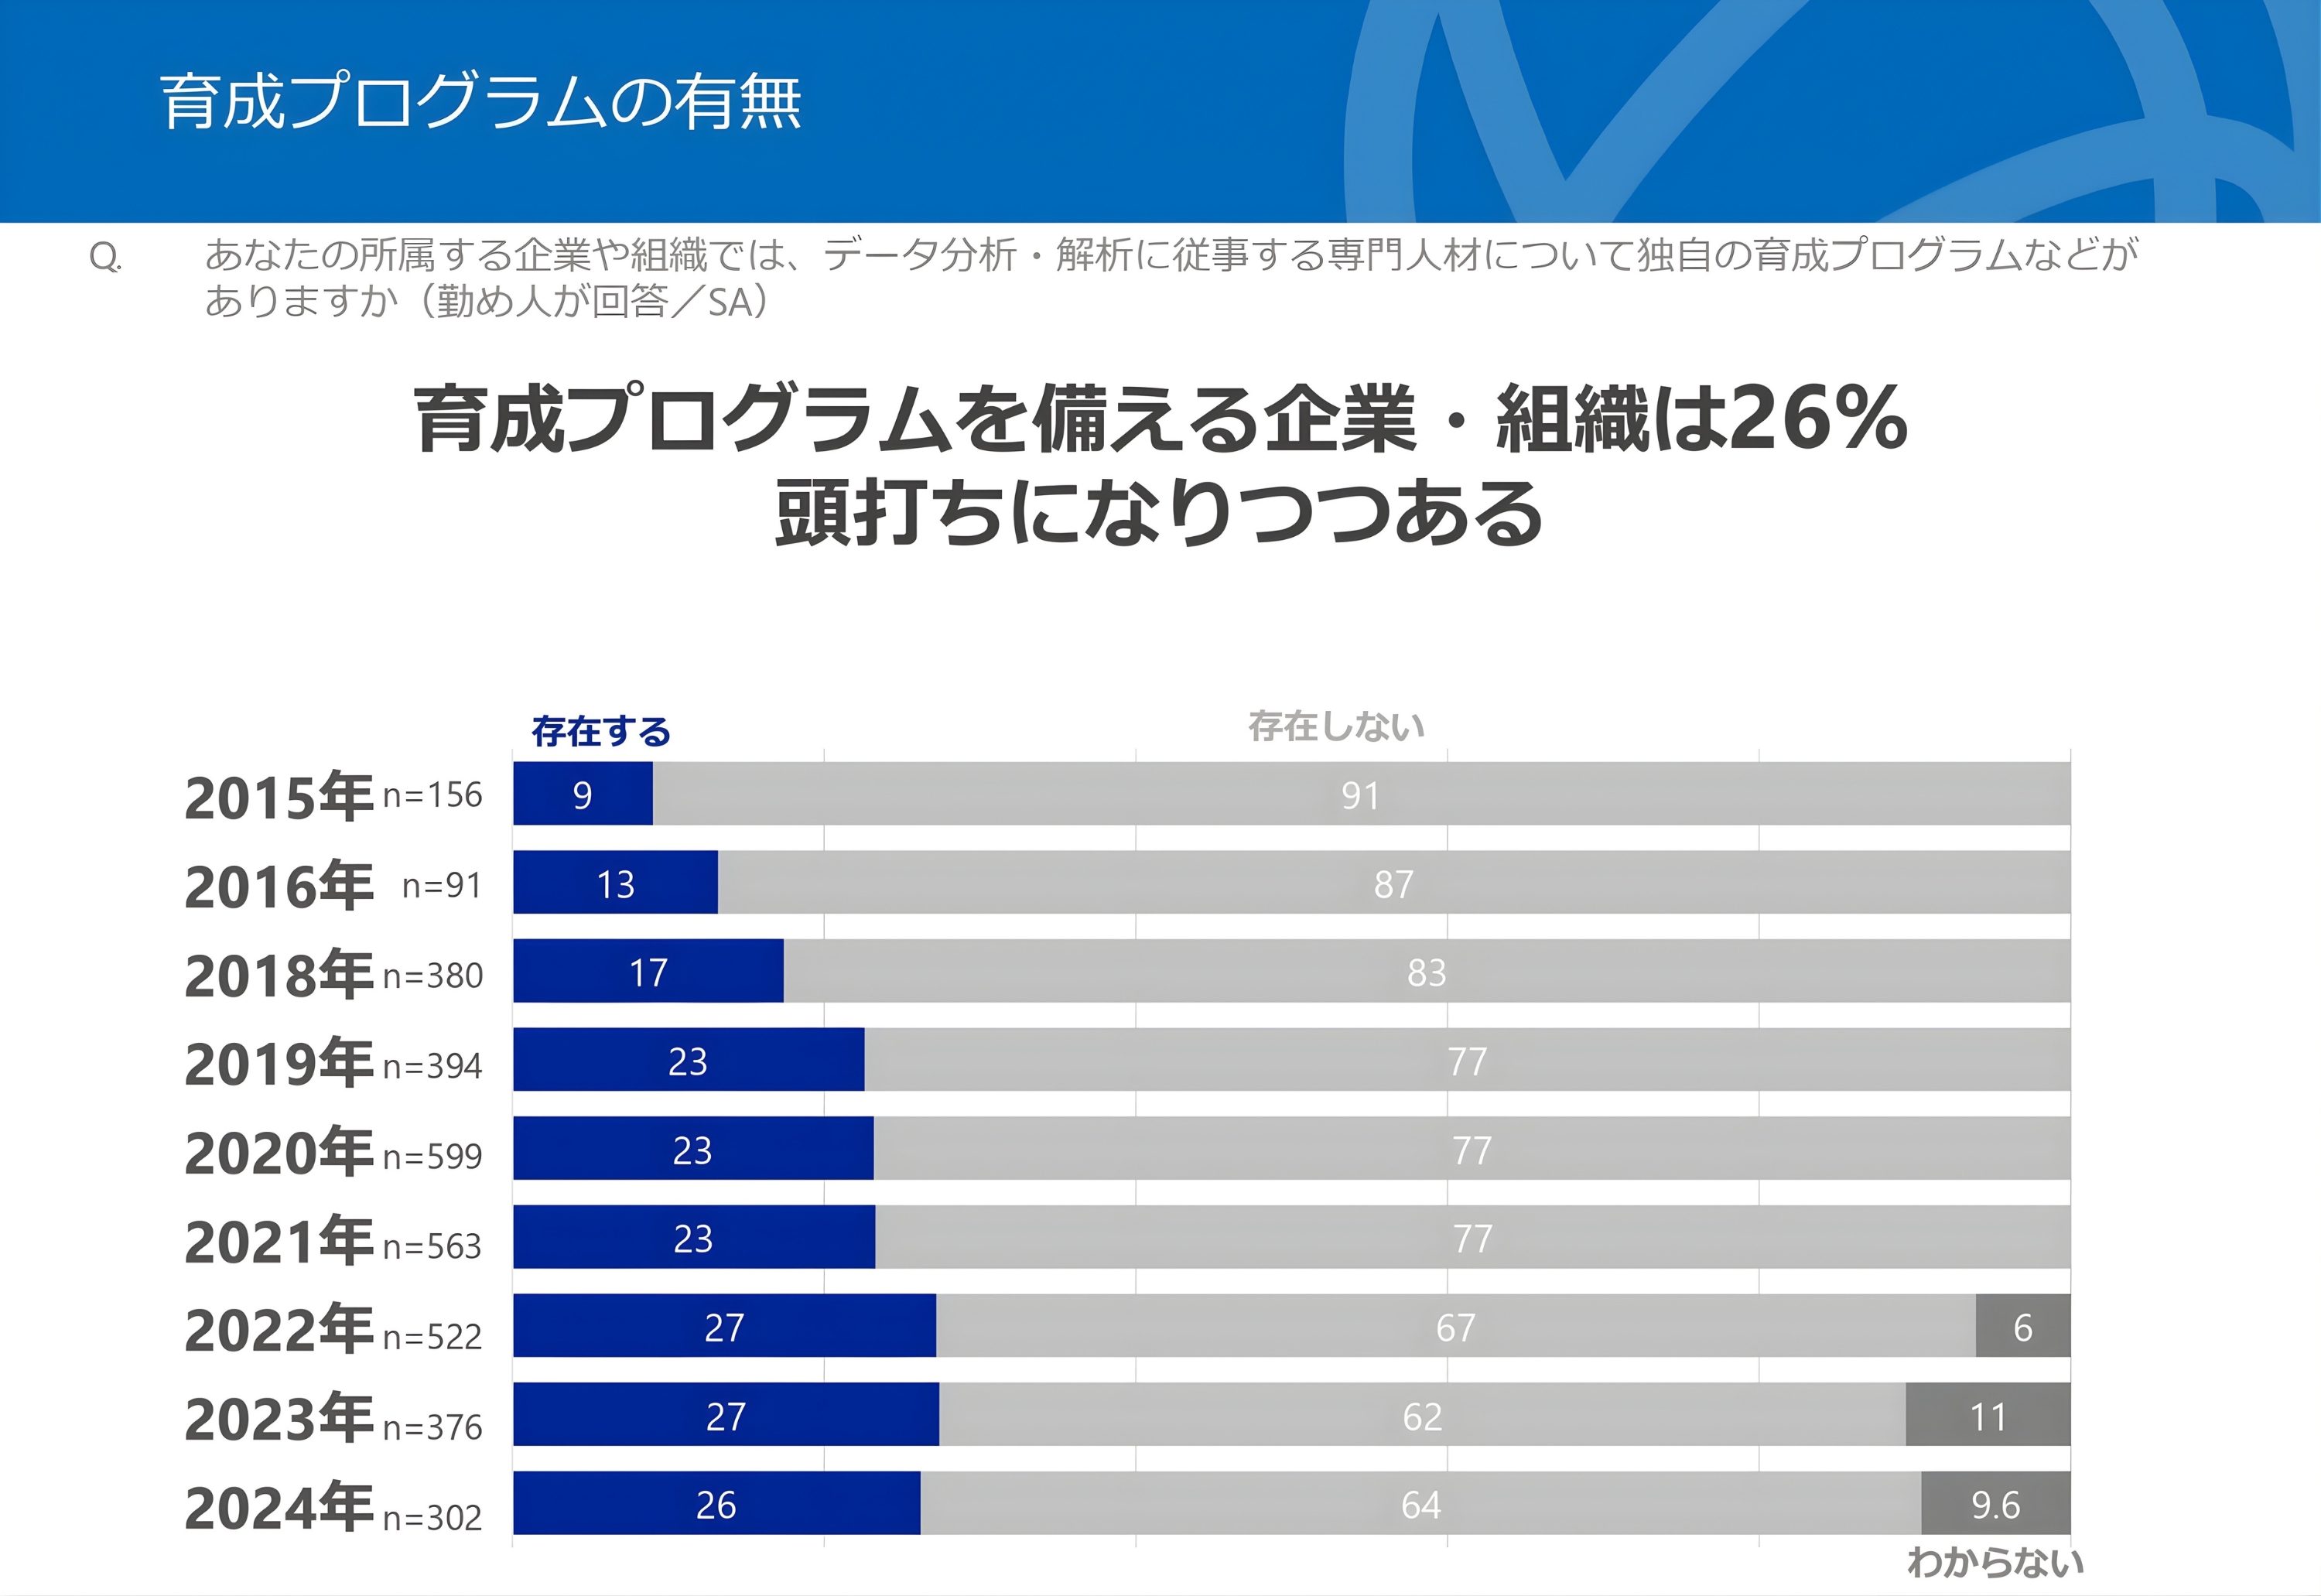
さらに,同調査(図6[3])では,専門人材の育成プログラムを備えている企業は26%にとどまっている[3].これは,企業側の現場で指導・支援を担える人材の育成体制が構造的に不十分であることも示されている.
これらの要因が相互に重なり合うことにより,データを利活用して仮説検証を行えるようになるまでの道筋が不明瞭となり,初学者が学習内容を実務に結び付けることを阻害している.
要するに,この状況の根本的な原因は,従来の技術先行型の学習方法と,実践的な指導・体制の不足という2つの主要な問題にあると考えられる.
1.6 研究の目的
本研究は,第1.5節までに明らかになった課題,すなわち従来の「技術先行型の学習方法」と「実践的な指導・体制の不足」に起因する「データ利活用人材の不足」と「初学者にとっての実践の難しさ」を解決することを目的とする.
具体的には,データ分析を専門としない実務者が,自律的にデータを利活用した仮説検証を実践できるスキルを獲得するための,初学者向けの身近な例から本格的なビジネス活用例まで,難易度を段階的に上げながら繰り返し実践するトレーニング方法を提示する.
これにより,DX推進に不可欠な現場におけるデータ利活用の実践力を底上げし,企業内でその役割を担える人材が増えることで,データ利活用人材不足の緩和に寄与することを目指す.
1.7 研究方法の概要
本研究では,従来の主観的な意思決定プロセスである「KKD(経験・勘・度胸)」に代わる,仮説構築とデータによる検証に基づく客観的な意思決定プロセスとして,新たに「シン・KKD(仮説・検証・データ)」(図7[4])の思考プロセス[4]を提唱する.
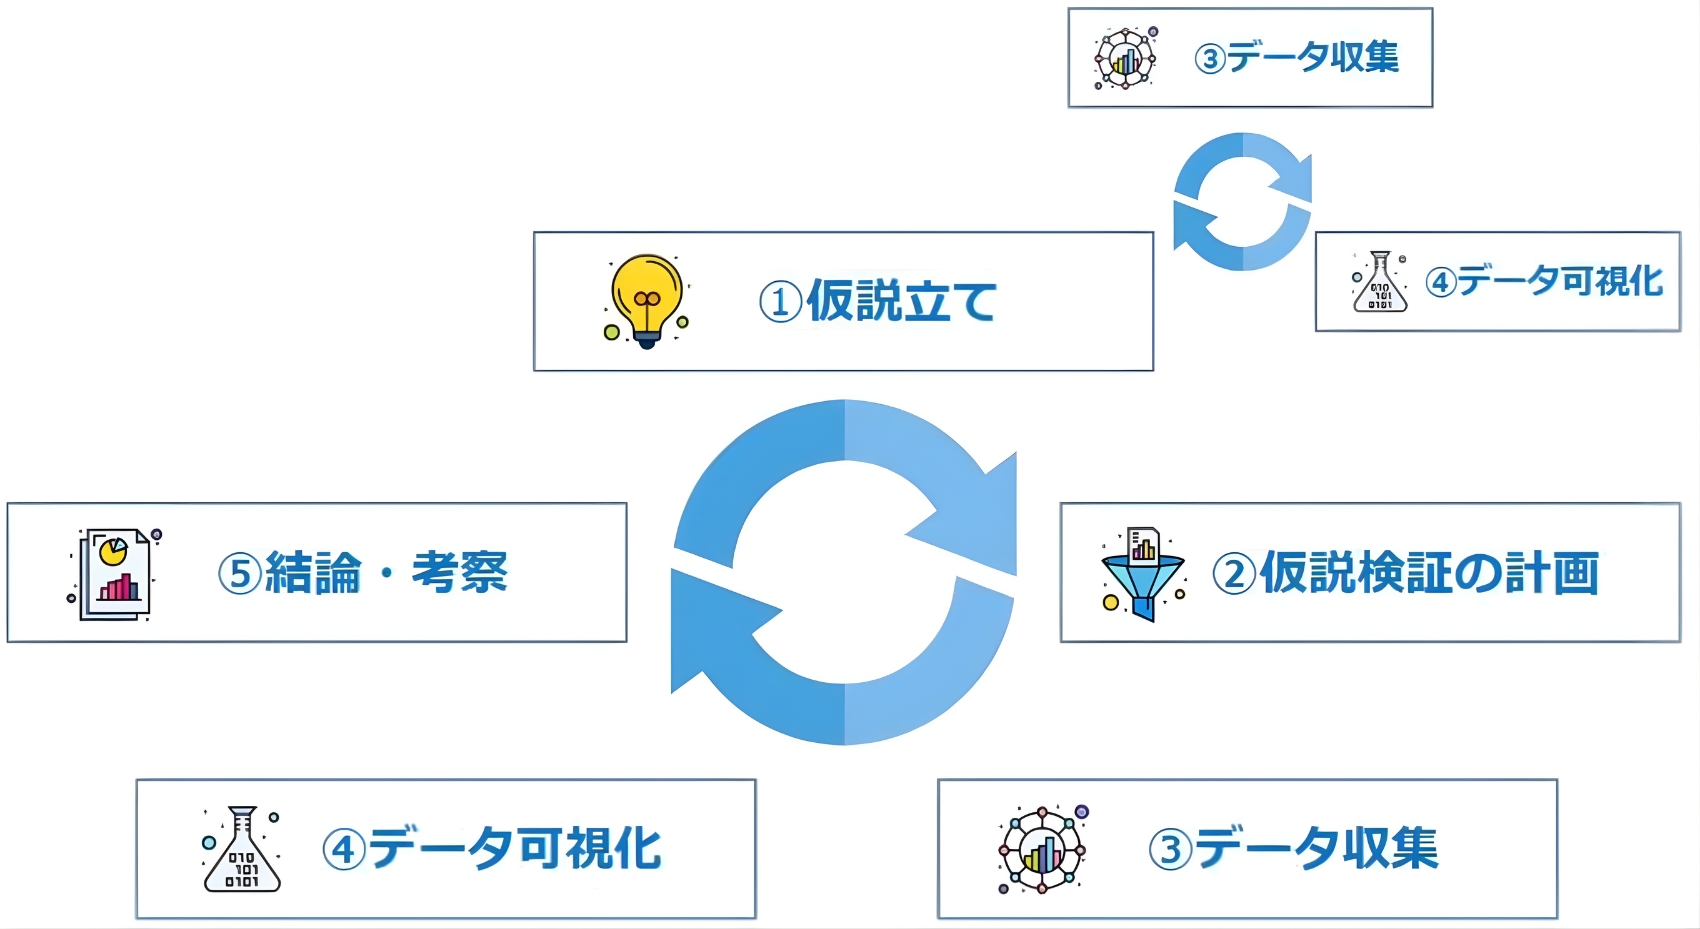
そして,この思考プロセスと,それに必要なスキルを初学者が段階的に習得できる学習プロセスを統合した体系的な枠組みを,本研究のフレームワークと定義し,これを具現化した教材としてトレーニングブックを開発した.このトレーニングブックは,「理論編」で「シン・KKD」の思考プロセスを学び,「実践編」で演習問題を通じてデータ収集・可視化を含む全プロセスを経験することで,自律的なデータ利活用を可能にする人材の育成を支援する.
本稿では,フレームワークの検証活動を通じて得られた成果と,その有効性について考察する.
1.8 研究結果の概要
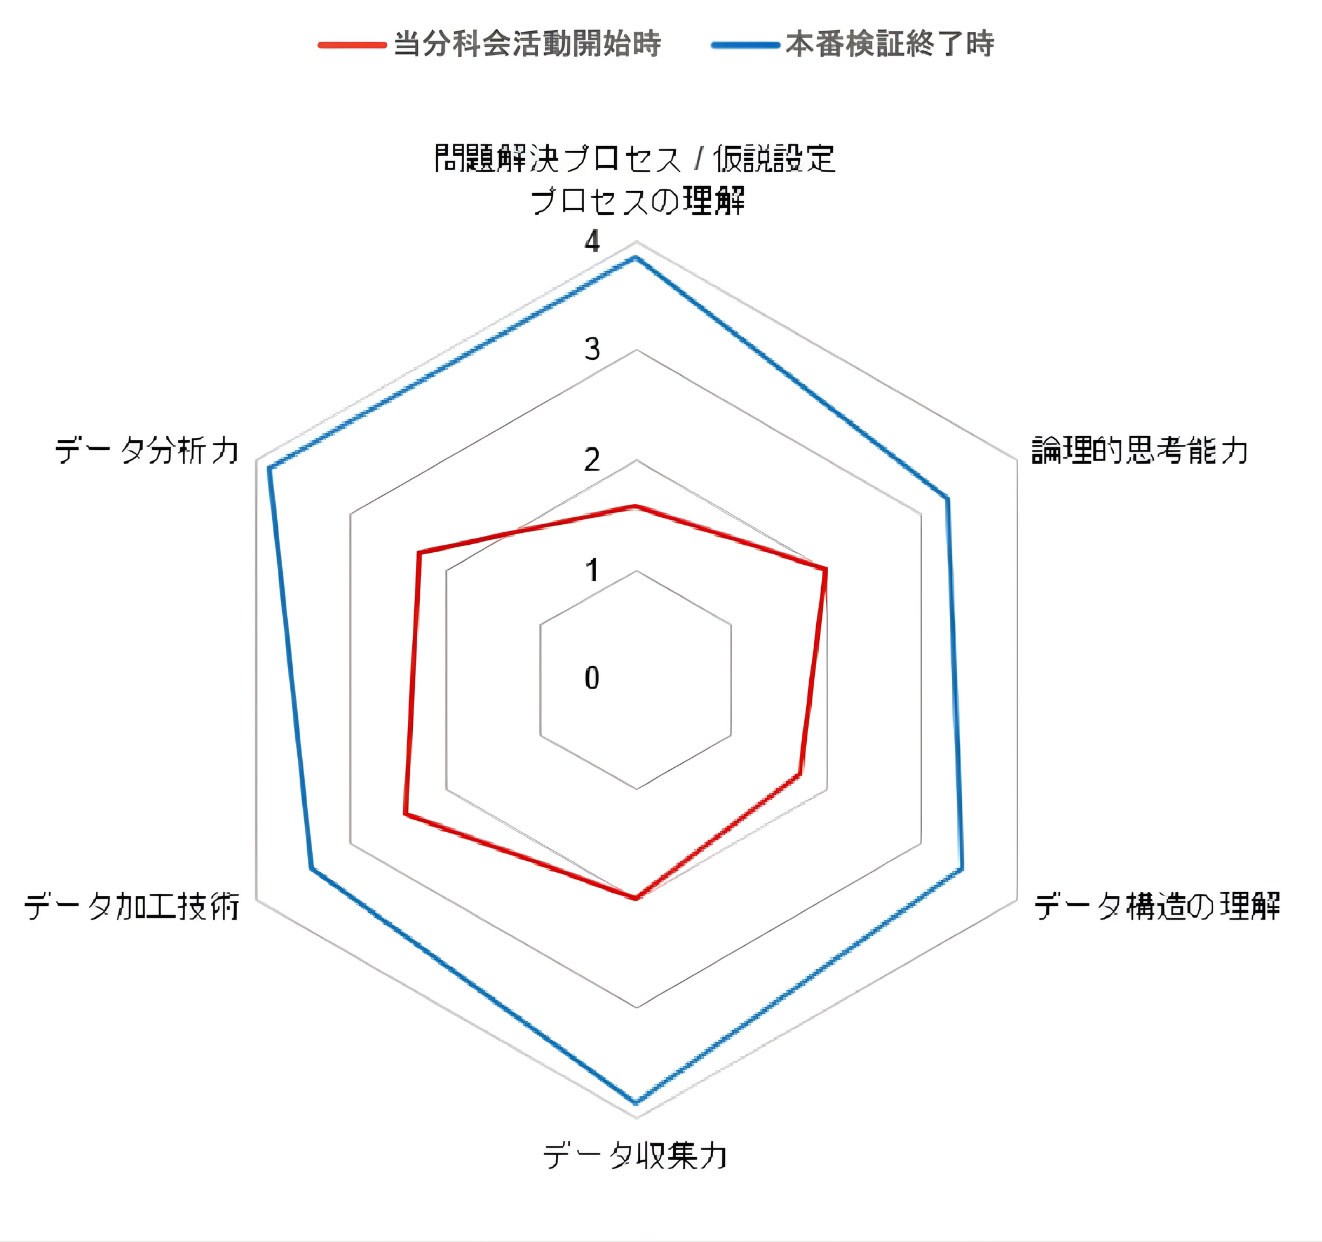
本研究では,フレームワークに基づき検証活動を実施した.その結果,データ利活用初学者からなるトレーニング対象集団において,データ利活用に必要なスキルレベル(表1[4],表2[4])が定量的に向上したことを確認した(図8).なお,このスキルレベルの測定に用いた必要スキルは表1[4]に,スキルレベルの指標は表2[4]に示す.これらの必要スキルの具体的な定義は,本研究で開発したトレーニングブック[4]に記述されている.
また,フレームワークを通じて身につけた実践力の確認として,検証対象者の一人は本番検証の完了後に「実業務での最適な座席数の算出」といった実践的なテーマを,データを利活用して自律的に実践した.この事実は,実務者がデータ利活用のプロセスを自律的に回せるようになるという,フレームワークの有効性を裏付けるものである.
これらの結果は,本研究が目的とした「初学者が自律的に仮説検証を実践できるスキルを獲得する」という目標が達成可能であることを実証するものである.
2.研究方法
第1章で述べたとおり,本研究の目的は,従来の「技術先行型の学習方法」と「実践的な指導・体制の不足」に起因するデータ利活用人材の不足と,初学者にとっての実践の難しさを解決することにある.本研究では,この目的を達成するため,第1章で定義したフレームワークの有効性を検証する.
本章では,このフレームワークの有効性を検証するための具体的な実施方法,実施内容について記述する.
2.1 実施方法
本研究の主要なアプローチは,以下の4つの活動で構成される.
- 「シン・KKD」の提唱と体系化
従来の主観的な意思決定プロセスである「KKD」に代わる,仮説構築とデータによる検証に基づく客観的な意思決定プロセスとして,「シン・KKD」の思考プロセスを提唱し,その体系化を行った(表3[4]).「シン・KKD」はスキル習得のための実用的な手順ではなく,データ利活用の全工程を網羅した体系的な思考プロセスである.
- トレーニングブックの開発
「シン・KKD」の実践手法を集約し,データ利活用初学者が自律的にスキルを習得できることを目指したトレーニングブックを開発した.このトレーニングブックは,思考プロセスを学ぶ「理論編」と,演習問題を通じて全プロセスを体験する「実践編」で構成されている.
- ソリューション研究会での検証活動
筆者らが参加したソリューション研究会「ビジネスに貢献するデータ活用分科会(以後,分科会)」内のデータ利活用初学者8名(以後,検証対象者)を対象に,開発したトレーニングブックの有効性検証を実施した.検証対象者は,データ利活用に興味関心のある業務経験年数2〜20年前後のメンバーで構成される(表4).この検証を通じて,トレーニングブックが具現化するフレームワークの学習効果を検証した.
表4 分科会メンバー属性 属性 区分:人数 職種 営業:3名,開発/エンジニア:3名,
社内DX担当:2名,R&D:1名業務領域 IT・情報システム:6名,金融:1名,
製造:1名,建設:1名データ取り扱い経験 データ分析専門職:1名,
業務での利用経験あり:2名,経験なし:6名 - トレーニングブックのブラッシュアップ
後に詳述する本番検証の完了後,トレーニングブックの品質向上を目的として,分科会外の協力者8名にレビューを依頼し,ブラッシュアップを行った.この活動で得られた49件の指摘をトレーニングブックに反映させるとともに,協力者からは「データ分析を行う上での不明点に対するフォローが記載されていて,『データ利活用』初心者の私でも途中でも諦めず読み進めることができました.」といったコメントが得られ,定性的ではあるが本フレームワークの有効性が示唆された.
2.2 実施内容
本節では,第2.1節で述べた主要なアプローチのうち,フレームワークを具現化する「トレーニングブックの開発」と,その有効性を検証した「ソリューション研究会での検証活動」に焦点を当て,その具体的な実施内容を記述する.
トレーニングブックの開発と検証は,「トレーニングブック作成にむけた準備(スモール検証)」と「トレーニングブックの有効性確認(本番検証)」の二段階で実施した.これは,主要な成果物である「トレーニングブック」の品質向上と,その有効性の客観的な検証を確実に行うための,体系的な手順である.
具体的には,まずスモール検証を通じて,トレーニングブックに盛り込むべき実践的な知見(ノウハウ)を蓄積するとともに,検証対象者間の「シン・KKD」に対する理解を平準化した.そして,この知見を反映して完成したトレーニングブックの有効性(初学者が自律的に仮説検証を実践できるか)を客観的に確認するため,段階的な難易度設定のもと,「本番検証」に移行した.
2.2.1 トレーニングブック作成にむけた準備(スモール検証)
- 目的
- 「トレーニングブック」に盛り込むべき実践的な知見を蓄積する.
- 検証対象者間の「シン・KKD」に対する理解を平準化する.
- 期間
- 2024年7月下旬~9月上旬(約2カ月間)
- 内容
- KKD比較テーマでの実践:「シン・KKD」の思考プロセスをまとめた概要ドキュメントを用い,「賃貸物件を探す」などのテーマで,従来の「KKD」によるアプローチと比較を行った.
- 実データ活用テーマでの実践:「業務時間分析」や「運動パフォーマンスの向上」といった,自身のスケジュールデータやオープンデータを活用したデータ収集・可視化のプロセスを実践できるテーマで繰り返し実践を行った.
- 成果
- スモール検証を通じて,「あるべき姿」と「現状」の差異から問題・課題を導く方法や,「あるべき姿」を定量的・定性的に記載するといった具体的な知見を収集し,トレーニングブックに盛り込む内容として精査した.
2.2.2 トレーニングブックの有効性確認(本番検証)
- 目的
- スモール検証を経て完成した「トレーニングブック」の有効性(初学者が自律的に仮説検証を実践できるか)を客観的に確認する.
- 期間
- 2024年10月(1カ月間)
- 内容
- 実践活動:フレームワークの基礎となる「シン・KKD」の思考プロセスを学ぶ「理論編」の内容を踏まえ,初学者が「シン・KKD」の全工程を体験できるよう活動を実施した.難易度を段階的に設定した演習問題として,「クラス成績向上」や「健康寿命延伸の検討」に取り組んだ.演習問題は,初学者の予備知識に依存しない汎用性の高いテーマとなるよう設定した.
- スキル評価:検証前後のスキルレベルの変化を測定するため,第1.8節で説明した「必要スキル」と「スキルレベルの指標」を用いて,検証対象者のスキルレベルを評価した.
- アウトプット収集:本番検証期間を通じて,各メンバーによる仮説検証の実践結果(仮説立案から結果の解釈・活用までのアウトプット)を収集した.
2.2.3 有効性評価のためのデータ収集と整理
本番検証の終了後,トレーニングブックが具現化するフレームワークの有効性を評価するため,以下の客観的なデータの収集と整理を行った.
- スキルレベルの測定結果
第1章表1,表2で示した「必要スキル」と「スキルレベルの指標」に基づき,検証対象集団のトレーニング前後におけるデータ利活用に必要な各スキル項目のレベルの変化を測定し,集計した.
- 検証活動のアウトプット
スモール検証および本番検証の「シン・KKD」の各サイクルで得られたアウトプット(仮説の内容,検証したデータ,考察結果など)を収集した.分科会内のデータ利活用有識者1名がその適切性・妥当性を都度確認した.
2.3 有効性評価の詳細
本研究で提案するフレームワークの有効性を客観的に評価するため,第2.2節で収集・整理したデータに対し,以下の手法を用いて分析を行った.
- スキルレベルの変化による評価
検証対象者の本番検証前後におけるスキルレベルの変化を把握するため,分科会活動開始時のスキルレベルと本番検証後のスキルレベルを分析対象とした.
対象者が8名と少数であるため,統計的検定による仮説検証は行わず,スコアの中央値および四分位範囲の変化を記述統計として算出した.
- アウトプットの定性的評価
収集した検証活動のアウトプットに基づき,分科会内のデータ利活用有識者による定性的な評価を行った.
表3で示した「シン・KKD」の思考プロセスの各手順ごとの実施内容を遂行できているかを評価した.特に③データ収集と④データ可視化の手順について統計学的な視点で作成したグラフや分析結果の有効性の評価を実施した.
フレームワークの有効性に関する詳細な評価結果は第3章で述べる.
3.研究結果
3.1 評価結果の概要
第2章で述べた方法に基づき,提案したフレームワークの有効性を検証した.
本章では,表1,表2に基づくスキルレベルの前後比較という“準定量的”記述統計を主結果として報告する.なお,スキルレベルは定性的評価をカテゴリー化したものであり,連続的な数値ではない.そのため,改善効果については,検証対象者が創出したアウトプットに対して,分科会内のデータ利活用有識者が第2.2.3項で説明した質的レビューを実施し,定量的結果の妥当性を補強した.
全体として,検証対象者全員において,データ利活用に必要なスキル向上が確認された.特に顕著だったのは,仮説立案からデータ利活用までの一連の流れを自律的に進められるようになった点である.データ利活用初学者であった検証対象者が,フレームワークに沿った段階的な学習を経て,自ら課題を設定し,仮説を立て,データを用いて検証するというデータ利活用の一連のプロセスを実践できるようになった.
3.2 スキル向上の詳細
第2章で設定した「シン・KKDスキル一覧」に基づいて,検証対象者のトレーニング前後におけるスキルレベルの変化を測定したところ,主要なスキル項目において明確な向上が継続的に確認された(図9).この結果は,検証期間を通じて有識者がアウトプットの妥当性を確認しているため,実践力の向上を示す定性的な裏付けも兼ねている.
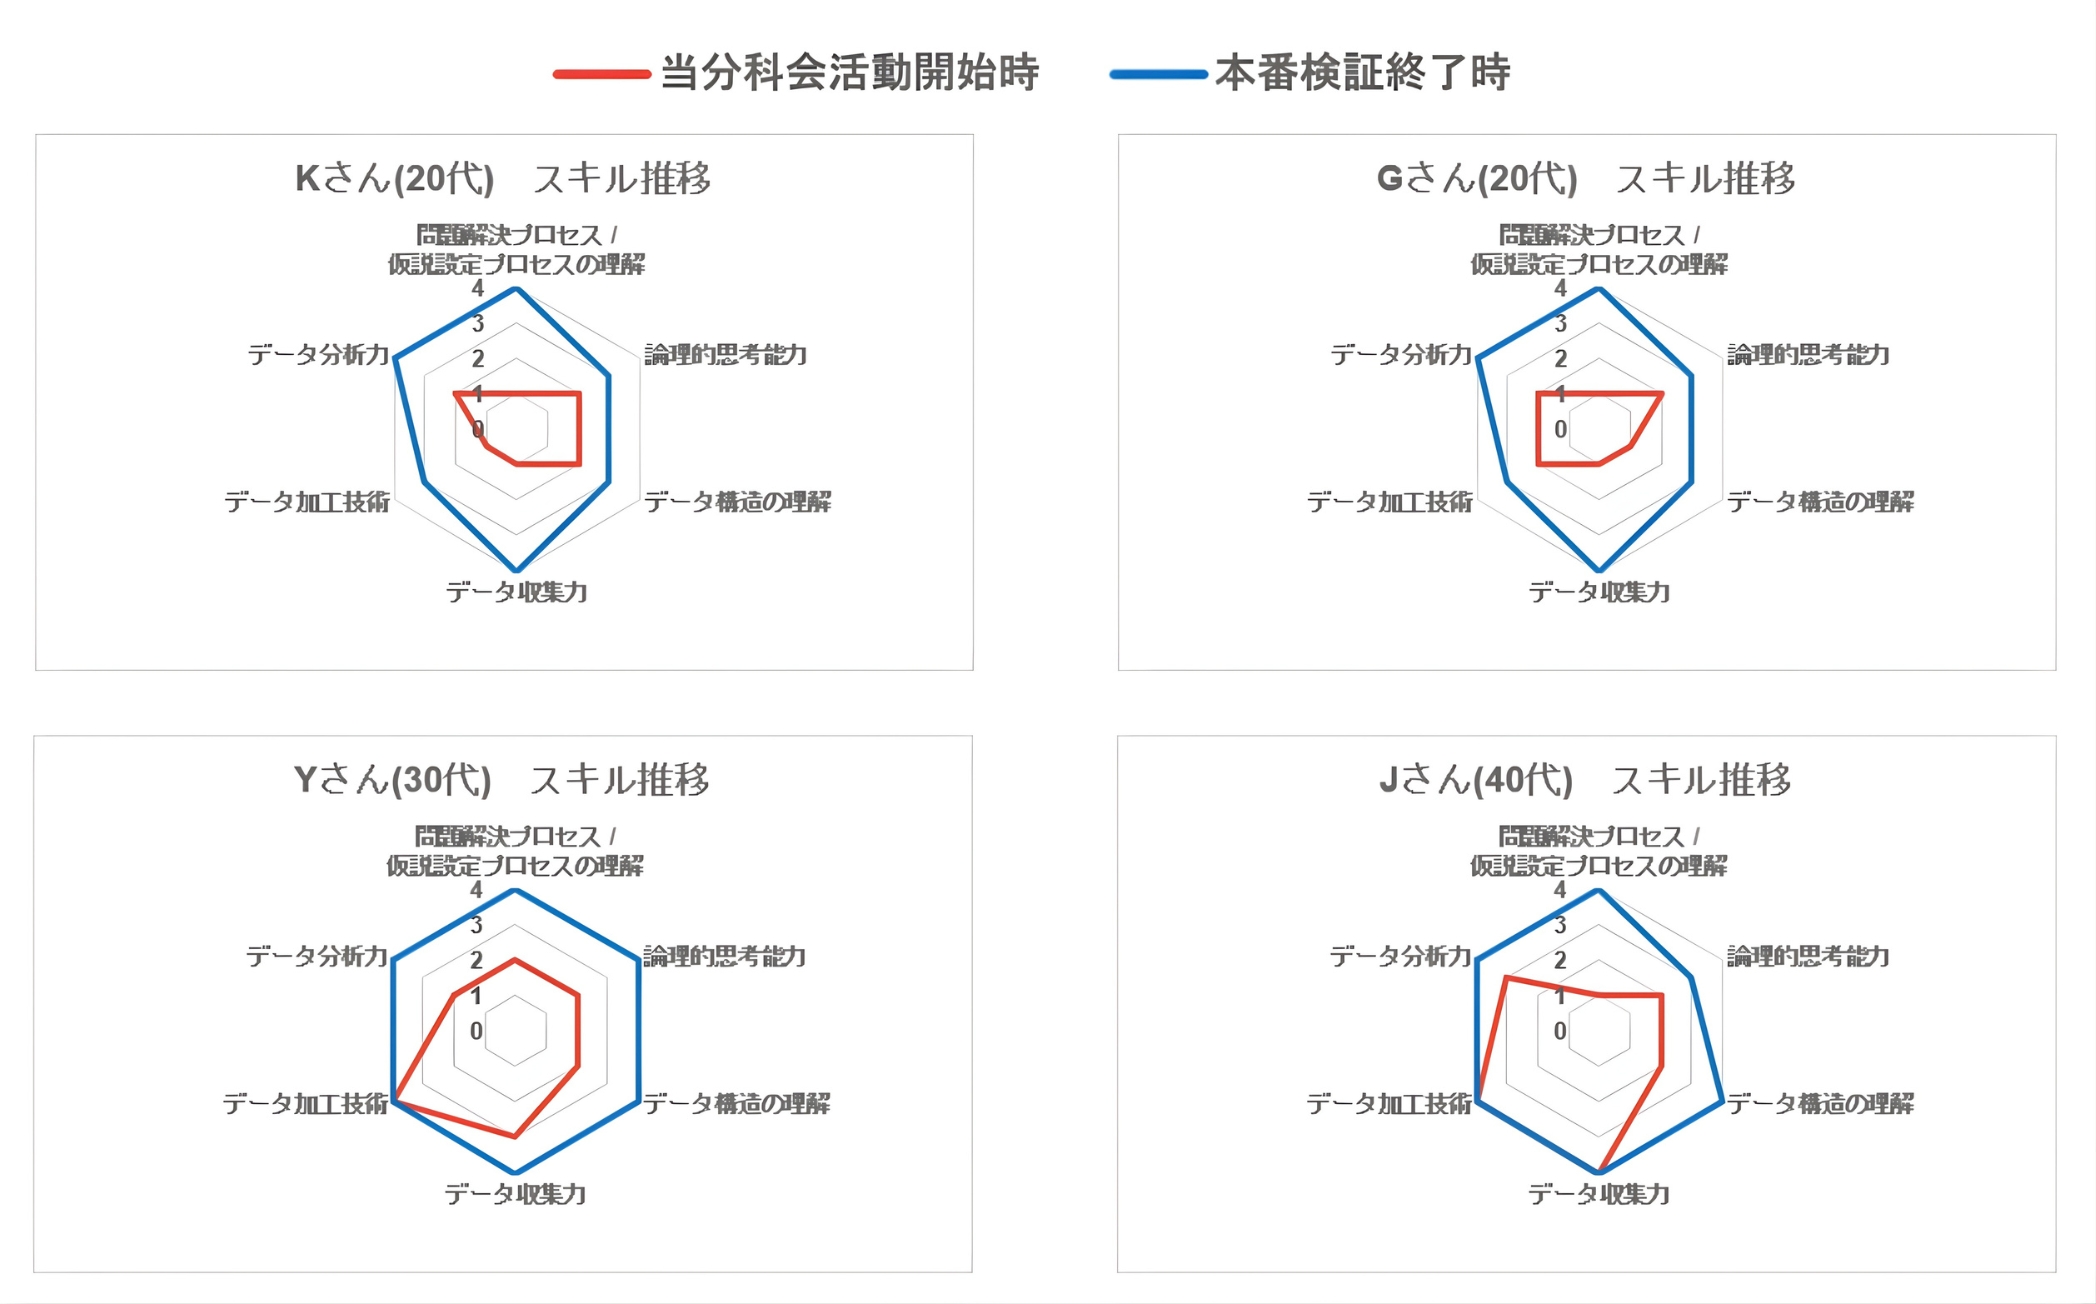
なお,各スキルレベルについて,検証対象者のトレーニング前後の平均値を集計したところ,「問題解決プロセス/仮説設定プロセスの理解」が最も向上したスキルと確認された(表5).
| スキル | 分科会開始時 | 本番検証終了時 | レベルの変化 |
|---|---|---|---|
| 問題解決プロセス/ 仮説設定プロセスの理解 |
1.57 | 3.86 | +2.29 |
| 論理的思考能力 | 2.0 | 3.29 | +1.29 |
| データ構造の理解 | 1.71 | 3.43 | +1.72 |
| データ収集力 | 2.0 | 3.86 | +1.86 |
| データ加工技術 | 2.43 | 3.43 | +1.0 |
| データ分析力 | 2.29 | 3.86 | +1.57 |
また,準定量的変化について,各スキル項目における具体的な変化内容を以下に詳述する.
- 問題解決プロセス/仮説設定プロセスの理解
仮説設定において,漠然とした問題意識を具体的かつ検証可能な仮説として明文化する力が向上した.また,「あるべき姿」と「現状」の差異から「問題」を導出し,具体的な課題設定につなげるプロセスが検証対象者に定着した.検証目的を明確にする習慣が身についたことが,この向上に寄与している.
- 論理的思考能力
仮説検証のプロセスを論理的に組み立て,検証結果から妥当な結論を導く力が向上した.「なぜそのデータが必要か」「なぜその可視化方法が適切か」といった問いに対して,根拠を持って説明できるようになった.
- データ構造の理解・データ収集力・データ加工技術
オープンデータを活用した検証テーマにより,適切なデータの選定,データの前処理,基本的な集計・可視化といった一連の作業を自力で進められるようになった.特に,仮説検証に必要なデータがどのような構造で提供されているかを理解し,目的に応じて加工する技術が身についた.
- データ分析力(結果の解釈・活用を含む)
フレームワークを用いたスモール検証および本番検証の実践により,単にデータを集計・可視化するだけでなく,その結果からどのような示唆が得られるのかを考察し,次のアクションにつなげる力が養われた.結果を整理して次のアクションを計画することにより,実際のビジネスシーンでデータ利活用を行う上で不可欠な能力が向上した.
3.3 段階的学習の効果
身近なテーマから本格的なビジネス活用テーマへと段階的に難易度を上げるアプローチは,データ利活用初学者にとって特に効果的であったと確認できた.初学者にとって,いきなり複雑なビジネスデータを扱うことは心理的なハードルが高いが,まず身近で理解しやすいテーマから始めることで,データ分析の基本的な流れを無理なく習得できた.
また,繰り返し実践することがスキル習得にきわめて有効であることも確認された.初学者向けの身近な例から本格的なビジネス活用例まで,難易度を段階的に上げながら繰り返し実践するトレーニング方法により,知識の定着が促進されるとともに,さまざまな状況に応用できる汎用的なスキルとして身についた.この「繰り返しの実践」がスキル定着に大きく貢献していることが,活動を通じて明らかになった.
4.考察
4.1 本研究によって得られた知見
本研究における検証活動を通じて,データ利活用初学者のスキル習得に関する3つの重要な知見が得られた.
- 問題設定を起点とするフレームワークの有効性
初学者が抱く「何から始めればよいか」という戸惑いは,スキルの欠如以上に,ビジネス課題とデータの紐付けプロセスの不明瞭さに起因している.本研究で提唱した「シン・KKD」は「問題設定(仮説立て)」を最優先事項として体系化したことで,初学者が技術的煩雑さに囚われず,自律的に検証を進めることを可能にした.
この有効性は,検証対象者のスキル評価においても裏付けられた.特に,検証前後で最も向上したスキル項目である「問題解決プロセス/仮説設定プロセスの理解」は,参加者が漠然とした問題意識を具体的かつ検証可能な仮説として明文化する力と検証目的を明確にする習慣が身についたことを示している(第3.2節参照).この事実は,「シン・KKD」が初学者の問題設定能力を飛躍的に向上させるための,技術的な煩雑さに囚われない設計になっていることの定量的裏付けとなる.
- 段階的アプローチによる「心理的ハードル」の解消
日常的なテーマ(賃貸物件探し等)から,業務分析,オープンデータ活用へと段階的に難易度を引き上げたスモール検証の積み重ねは,学習者の自己効力感を高める効果があった.これにより,データ利活用を「専門家の仕事」から「自分たちの課題解決の手段」へと意識変革させることが確認された.
- 「繰り返し」による汎用スキルの定着
異なるテーマで「シン・KKD」のプロセスを繰り返すことにより,特定のデータ形式に依存しない汎用的な論理的思考能力が養われた.本番検証において全メンバーが一定水準(レベル3〜4)のスキルに到達した(第1章 図8到達スキルレベル(メンバー平均)).この事実は,本手法が類似の初学者集団に対しても有効である可能性を示唆している.また,データ利活用に不可欠な基礎スキルについても同様の効果が見られた.「データ構造の理解」や「データ収集力」が大きく向上した背景には,オープンデータを活用した検証テーマでの実践を通じ,特定のデータ形式に依存しない適切なデータの選定,前処理,基本的な集計・可視化といった一連の作業を自律的に進められる汎用的なスキルが定着したことが挙げられる(第3.2節参照).なお,これらデータ系スキルの中でも「データ加工技術」の伸び幅が相対的に小さかった.その理由は,日常的にExcel等を使用して業務を行っており,データ加工に慣れている検証対象者が多かった(最初からある程度のスキルが身に付いていた)からと考えられる.これは日常的に「繰り返し」を行う作業がスキルとして身に付いていると言える.しかし,本番検証終了時のスキルレベルが相対的に低いことを踏まえると,初期スキルが低い検証対象者のスキル定着をさらに図る必要がある.このため,今後のトレーニングにおいてデータ加工を伴う実践機会を増やすなどの拡張が必要であることも示唆された.
なお,知見が得られた一方で,本研究によるスキル習得に関する課題も得られた.
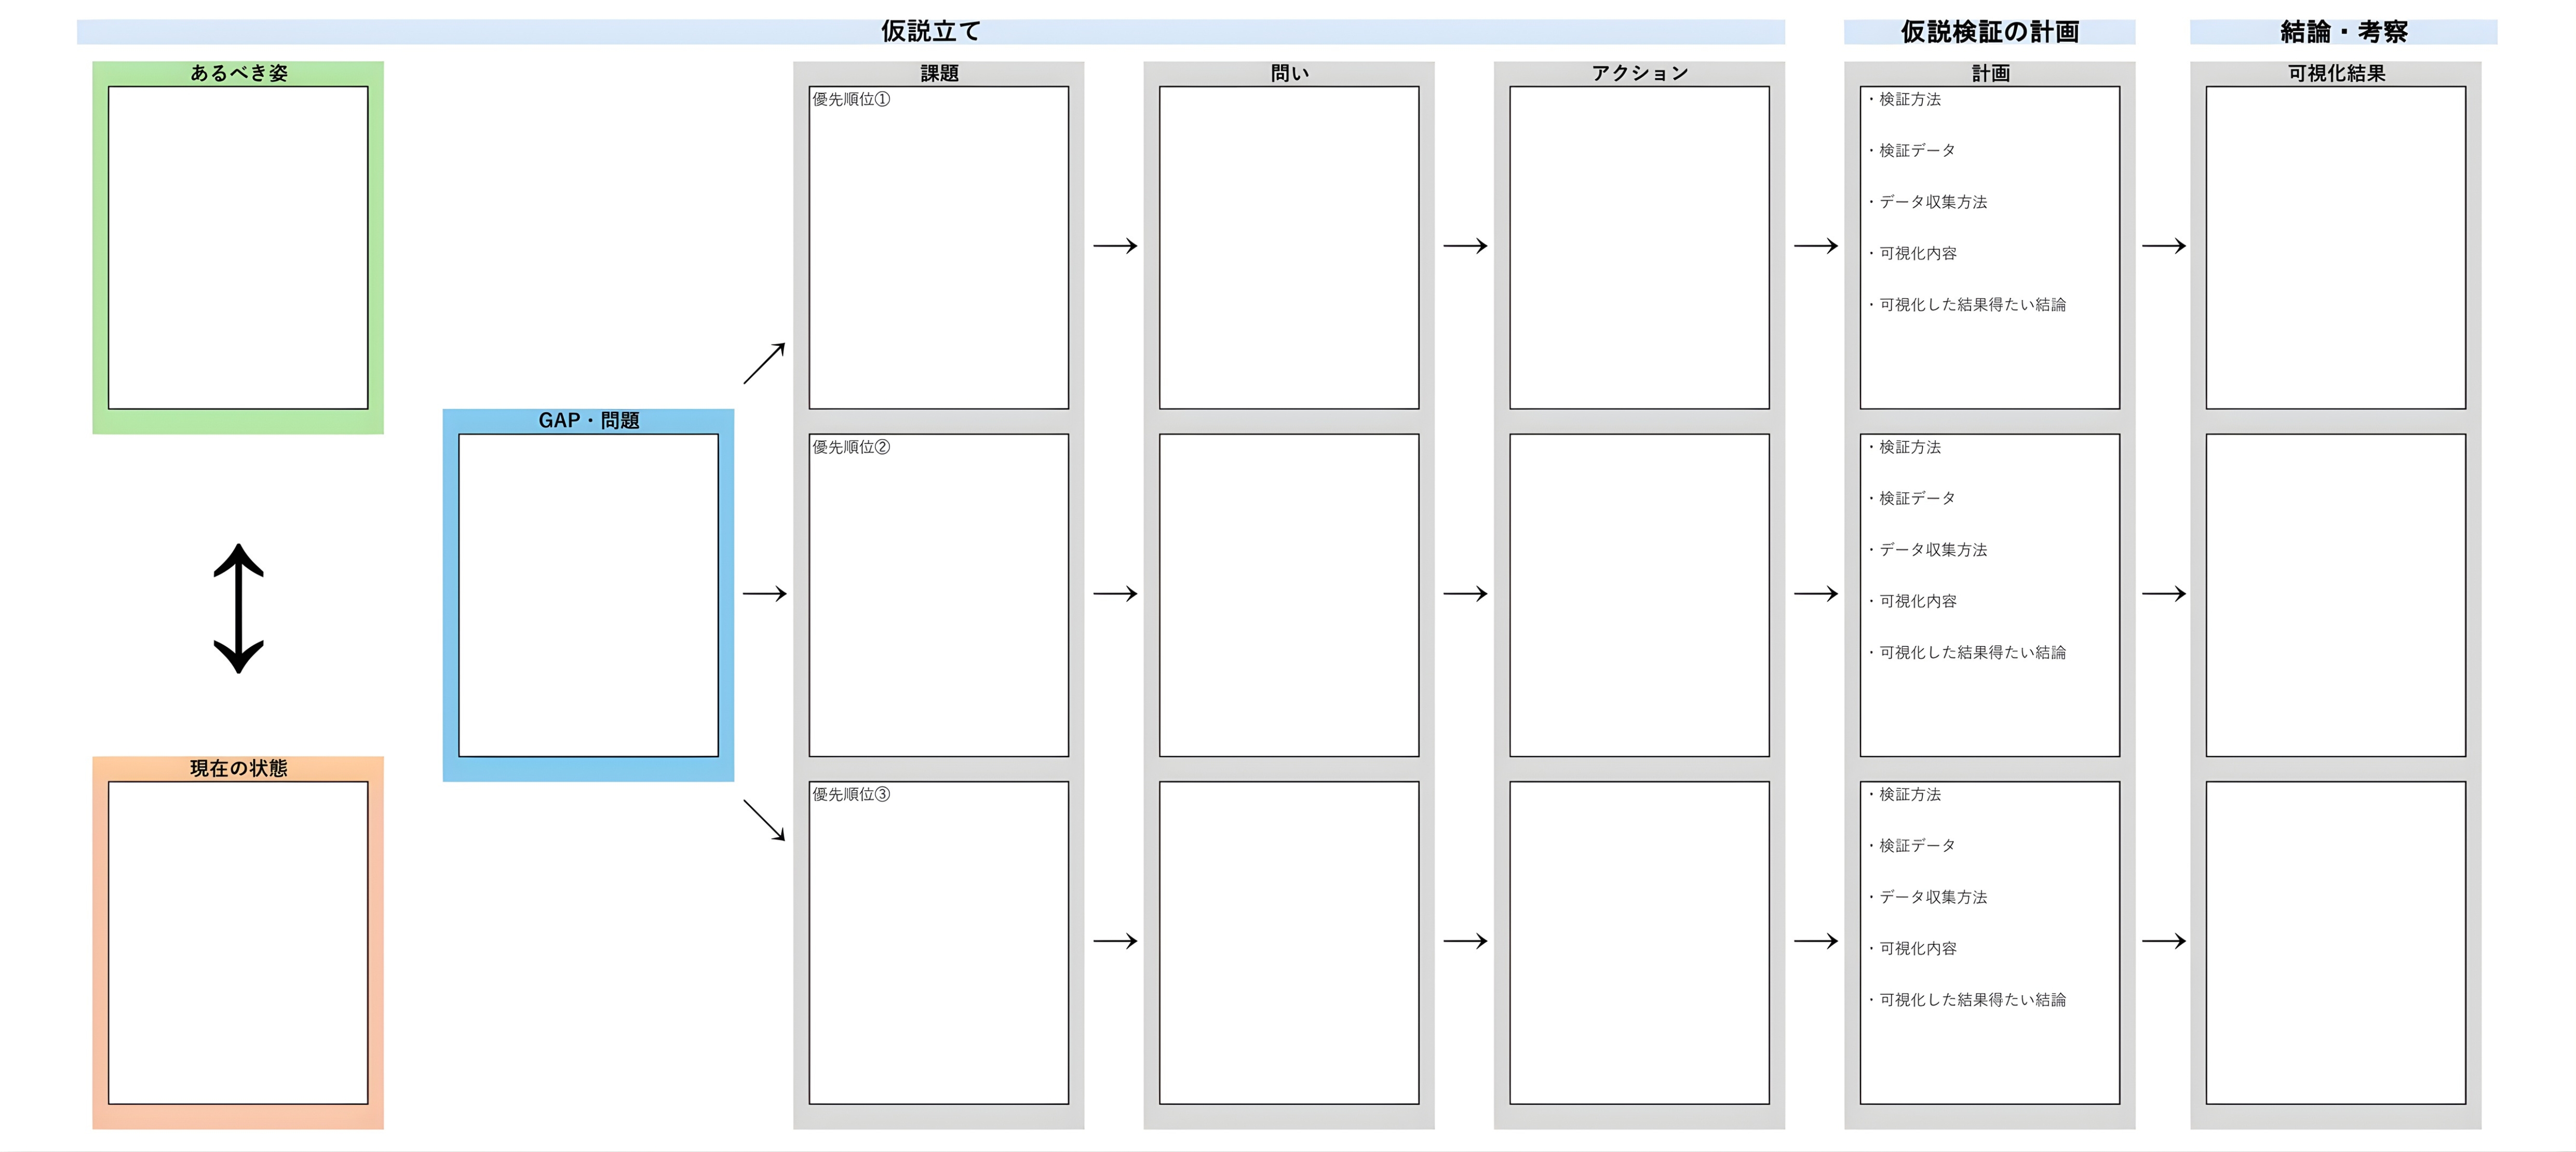
表5より,検証対象者における検証終了時の「論理的思考能力」のスキルレベル平均値が最も低かったことが確認されたが,その要因として問題に対して網羅的に,抜け漏れがなく考えられているか,という判断が難しい点が考えられる.スキルレベルをさらに上げるためには,「『シン・KKD』実践ワークシート」(図10)を活用し,抜け漏れなく項目を洗い出すことを繰り返していく必要がある.
4.2 既存対策との比較
本フレームワークは,従来の学習リソースと比較して以下の優位性を有する.
- 「技術先行型」から「課題解決型」への転換
統計手法やツールの操作習得に偏りがちな既存対策に対し,本手法は「なぜそのデータが必要か」という仮説立案を最優先としている.これは,文献[5]で指摘されている「データ分析を事業・業務に活かせる人材」の不足に対する直接的な解となり得る.
- OJT不足を補完する自習性の高さ
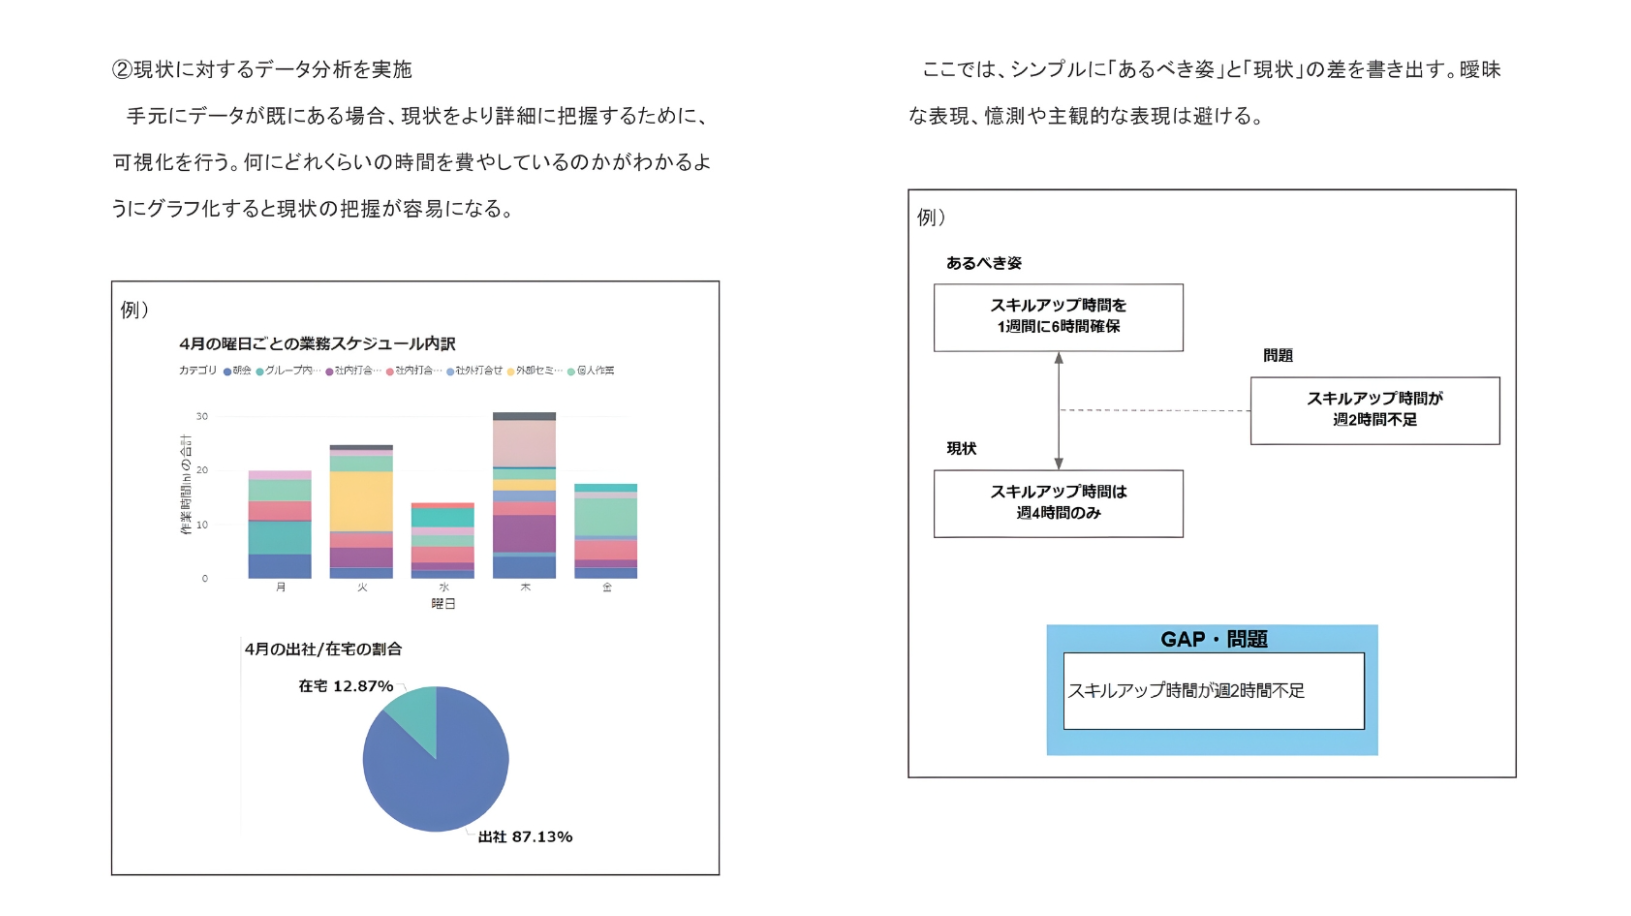
アンケート調査(第1章 図5 スキルアップ時の困りごと[3])で,「手本・指導者の不在」がスキルアップの阻害要因となる中で,体系化された「シン・KKD」の思考プロセスと「実践編」での豊富な実施例(図11[4])を備えた本トレーニングブックは,専門家による常時指導が困難な環境でも,初学者の自律的な学習を支える代替機能を果たしている.
4.3 初学者向けパッケージの新規性
本研究の新規性は,「初学者が自らデータを使いこなし,仮説検証を実践できるよう,仮説立案からデータ利活用までの全工程を体系化・明文化し,初学者向けの体系的な学習プログラムとして統合した点」にある.先行研究調査の結果(表6),高度な分析手法を説く文献は多々存在するものの,初学者が自ら「あるべき姿」を定義し,GAPを「問題」として抽出して,具体的な解決策を策定するまでの一連の思考プロセスを演習とともにパッケージ化した枠組みは確認されなかった.
| データソース | 調査期間 | 検索キーワード(検索式) | 確認方法 |
|---|---|---|---|
| Google Scholar |
2021年 ~ 2025年 |
「データ利活用」と,以下の語句を組み合わせた検索: フレームワーク,スキル習得,手順,手引き,初学者,ビジネス,体系化,実践,トレーニング,仮説検証 |
関連性の高いと思われる先行研究について,タイトル,要旨,目次等を確認 |
| NDL サーチ |
4.4 実務における再現のための推奨条件
本研究の検証プロセスおよび成果に基づき,初学者が実務で自律的なデータ利活用を再現するための推奨条件を以下の3点に整理する.
- 「成功体験」を優先したテーマ選定
初学者の教育においては,最初から複雑なビジネス課題を扱うのではなく,専門的な業務知識が不要で結果が想像しやすい身近なテーマから着手すべきである.この「スモールステップ」が,その後の難易度の高い課題に対する心理的障壁を取り払う鍵となる.
- 「思考の型」を定着させるための反復
一時的な知識習得にとどめず,異なるデータソースや問いに対して同一のフレームワークを繰り返し適用する機会を設けることが推奨される.本研究では「スモール検証」と「本番検証」を通じてプロセスを繰り返したことが,知識の定着と応用力の向上に大きく貢献した.
- 有識者による「プロセスの妥当性」の随時レビュー
初学者が自習において陥りやすい「仮説の甘さ」や「データの誤読」を防ぐため,各工程(仮説立案,可視化,考察)において有識者が適切性・妥当性を確認するフィードバック体制が望ましい.この伴走的な確認作業が,スキルの質的向上を担保する.
4.5 制約事項と限界
本研究の成果を実務へ応用するにあたっては,以下の制約を考慮する必要がある.
- 対象集団の学習意欲
今回の検証対象はソリューション研究会という比較的学習意欲が高い層に限定されているため,データ利活用に対する動機付けが低い層に対しても同等の効果が得られるかは未知数である.
- 取り扱うデータの性質
本研究ではExcel等による構造化データを主眼としており,テキストや画像,音声といった現代のビジネスで重要性が増している非構造化データの利活用については,本フレームワークのさらなる拡張が必要である.
- 長期的なスキル定着の未検証
本研究期間内(8カ月)でのスキル向上は確認されたが,活動終了後の実務において,このスキルがどの程度持続し,組織の意思決定文化を具体的に変革させたかについては,長期的な追跡調査が不可欠である.
- 特定の業界・業務への適用性
本フレームワークは,汎用的な「シン・KKD」の思考プロセスの習得に重点を置いているため,特定の業界(例:金融,製造)や業務(例:サプライチェーン管理,リスク分析),複雑なデータ構造,特有の専門知識や規制といった個別具体的な実務への対応には,業界知識等の補完が必要となる.
- 組織的な実践への波及と定着
個人のスキル向上が,必ずしも組織全体のデータ利活用文化の醸成や,データ駆動型経営への移行に直結するわけではない.第1.5節で指摘のとおり,組織的な指導体制の不足や,経営層の理解とデータ共有基盤の整備といった構造的な課題は,本フレームワーク単体では解決できず,個人のスキルアップを組織的な実践へ結びつける上での限界となる.
5.結論
5.1 本稿の結論
本研究では,データ分析を専門としない業務従事者が,自身の業務の中でデータを利活用し,仮説検証を実践できるスキルを獲得するための体系的なフレームワークを提案し,その有効性を検証した.
提案したフレームワークは,従来の「KKD」に代わる「シン・KKD」の考え方を基盤とし,仮説立案からデータ利活用までの全工程を体系化した思考プロセスと,スキル習得のためのトレーニング方法を統合した枠組みである.このフレームワークをトレーニングブックとして具現化し,初学者向けの身近な例から本格的なビジネス活用例まで,難易度を段階的に上げながら繰り返し実践するアプローチを採用した.
ソリューション研究会活動における検証の結果,多様なテーマや実際のデータを用いた仮説検証を実践することで,検証対象者全員のスキルレベルが定量的に向上したことを確認した(第1章 図8).また,「実業務での最適な座席数の算出」といった実践的なテーマにおいても,検証対象者の一人が自律的にデータ利活用のプロセスを実践できるようになったことが示された.
本研究の結論は,仮説立案からデータ利活用までを連続的に実施可能なフレームワークにより,初学者がスキルを継続的に習得でき,企業におけるデータ利活用人材不足の解消につながる可能性があるということである.本フレームワークは,「データは手元にあるが活用方法に悩む人」や「これからデータ利活用を始めたい初学者」にとって有用な内容である.
ただし,上記の結論が成立する条件には,第4.5節で明記した制約事項を踏まえる必要がある.具体的には,(1)本検証の対象集団は学習意欲が比較的高いソリューション研究会のメンバーに限定されており,動機付けが低い層への同等の効果は未知数である.(2)本フレームワークはExcel等による構造化データの利活用を主眼としており,テキスト・画像・音声といった非構造化データへの対応には拡張が必要である.(3)8カ月間の活動期間内でのスキル向上は確認されたものの,活動終了後の長期的な定着については追跡調査が不可欠である.(4)特定の業界・業務固有の専門知識や規制への対応には,業界知識等の補完が求められる.(5)個人のスキル向上が組織全体のデータ利活用文化の醸成に直結するわけではなく,組織的な指導体制や経営層の支援といった構造的課題は本フレームワーク単体では解決できない.これらの条件を前提とした上で,本フレームワークは初学者のスキル習得に有効であると結論づける.
本研究の意義は,以下の3点にまとめられる.
- データ利活用人材の裾野拡大
従来,データ分析は専門家の領域と捉えられがちであったが,本フレームワークにより,データ分析を専門としない業務従事者でも,実務の中でデータを活用できるようになる道筋が示された.これは,企業内でデータ利活用を担える人材層を広げ,DX推進の基盤を強化することに貢献する.
- 実践的なスキル習得方法論の提供
「何から始めればよいか分からない」という初学者の課題に対し,段階的なアプローチと具体的な演習を通じた学習方法を示すことで,独学でもスキル習得が可能な環境を提供した.
- 企業のデータ利活用文化の醸成への寄与
個人のスキル向上だけでなく,組織全体でデータに基づく意思決定を行う文化を育むための基盤を提供することができる.
5.2 本稿の新規性
本研究の新規性は,初学者が自らデータを使いこなし,仮説検証を実践できるよう,仮説立案からデータ利活用までの全工程を体系的に整理し,明文化した点にある.
既存の学習リソースや研修プログラムでは,データ分析の技術的な側面(統計手法,BIツールの操作,プログラミング等)に焦点が当たることが多い.それに対し,本研究では「なぜそのデータが必要か」という仮説立案のプロセスを最優先事項とし,ビジネス課題の設定から意思決定までの一連の思考プロセスを,初学者向けに具体的な演習とともに体系化した.
Google ScholarおよびNDLサーチによる文献調査の結果,高度な分析手法を説く文献は多々存在するものの,初学者が自ら「あるべき姿」を定義し,現状との差異を「問題」として抽出し,データに基づく仮説を立案し,検証し,アクションを策定するまでの一連のプロセスを,段階的な難易度設定とともに完全にパッケージ化した枠組みは確認されなかった.
また,本研究では「シン・KKD」という新たな概念を提唱し,従来の「KKD」に代わる,データに基づく客観的な意思決定プロセスの重要性を示した.この概念は,データ利活用の本質を初学者にも理解しやすい形で表現したものであり,実務者の意識変革を促す効果があることが検証活動を通じて確認された.
さらに,本研究では,理論的な知識の提供にとどまらず,トレーニングブックという具体的な実践ツールを開発し,その有効性を実証した.このトレーニングブックは,「理論編」で「シン・KKD」の思考プロセスを学び,「実践編」で演習問題を通じて全プロセスを経験することで,初学者でも自律的にデータ利活用を実践できるよう設計されている.この「理論と実践の統合」というアプローチも,本研究の重要な新規性である.
5.3 今後に残された課題
本研究を通じて一定の成果を得ることができたが,今後に残された課題も明確になった.以下,3つの主要な課題について述べる.
5.3.1 普及・定着化に関する課題
本フレームワークの効果は,ソリューション研究会という限定的な集団において確認されたが,より広範な展開と継続的な定着化については課題が残されている.
- 個人から組織への展開
本研究では個人のスキル向上にフォーカスしたが,組織全体でデータ利活用の文化を醸成するためには,経営層の理解と支援,組織横断的な取り組みが不可欠である.また,組織内でトレーニングを実施する際の体制構築や,フレームワークの導入プロセスについても,より詳細なガイドラインが必要となる.
- 組織から業界全体
異なる業界,異なる規模の企業において,本フレームワークがどの程度適用可能であるか,また業界特有の課題に対してどのようなカスタマイズが必要かについては,さらなる検証が求められる.
- 継続的な定着化の仕組み
トレーニング終了後も,習得したスキルを維持・向上させるためのフォローアップ体制や,実務での適用を促進する仕組みの構築が課題となる.
5.3.2 ビジネス適用に関する課題
本研究では,研究会活動というある程度保護された環境下での検証を行ったが,実際のビジネス現場での適用については以下の課題がある.
- 実務への適用方法の具体化
日常業務の中でトレーニングを実施する際の時間配分,上司や同僚の理解を得る方法,実務課題とトレーニング課題の統合など,実践的な適用方法について,より詳細なガイダンスが必要である.
- 業界別の活用事例の蓄積
製造業,小売業,サービス業など,業界ごとに扱うデータの性質や課題の特性が異なる.各業界における具体的な活用事例を蓄積し,それらを体系化することで,本フレームワークの実用性をさらに高めることができる.
- ROI(投資対効果)の測定
企業が本フレームワークを導入する際,トレーニングに要する時間とコストに対して,どの程度のビジネス成果が得られるかを定量的に示すことが,普及促進のために重要となる.
5.3.3 取り扱うデータに関する課題
本研究では,Excel等による構造化データを主眼に置いたトレーニングを実施したが,現代のビジネスシーンでは多様なデータ形式への対応が求められている.
- 非構造化データへの対応
テキストデータ(顧客の声,SNSの投稿など),画像データ(製品画像,設備の写真など),音声データ(コールセンターの録音など)は,ビジネスにおいて重要性が増している.これらのデータを利活用するためには,本フレームワークの拡張が必要である.
- データソースの多様化への対応
従来のExcelファイルに加え,データベース,API,IoTセンサーなど,さまざまなデータソースからデータを収集・統合する能力が求められている.初学者が段階的にこれらの技術を習得できるよう,トレーニング内容を拡充する必要がある.
- データ量の増大への対応
ビッグデータの時代において,従来のExcelでは扱えない大規模データの処理・分析技術についても,初学者向けの段階的な学習パスを提供することが課題となる.
6.総括
本稿は,データ分析を専門としない業務従事者が,自身の業務の中でデータを利活用し,仮説検証を実践できるスキルを獲得するための体系的なフレームワークとその有効性について検証した結果を報告したものである.
筆者らは,従来の主観的な意思決定プロセスである「KKD」に代わる,データに基づく客観的な「シン・KKD」の思考プロセスと,初学者が段階的に習得するためのトレーニング方法を統合した枠組みを提案した.
検証活動の結果,本フレームワークを適用した検証対象者全員において,データ利活用に必要なスキルレベルが定量的に向上し,さらには本番検証後に実務での自律的な実践が確認された.
これらの成果は,企業におけるデータ利活用人材の裾野拡大と,データに基づく意思決定を行う文化の醸成に貢献する,実践的なスキル習得方法論を提示するものと結論づける.
本稿が,データ利活用に課題を抱える実務者や,これからデータ利活用を志す初学者の一助となれば幸いである.
本研究実施の機会を与えてくださったソリューション研究会の関係者の方々に深く感謝申し上げます.また,本研究にともに参加し,議論を重ねた唐鎌圭佑氏,黒田祥平氏に心より感謝いたします.
ソリューション研究会の事務局として,本研究を多大にサポートしていただいた(株)アシスト 根井和美氏,寺田和歌子氏に,この場を借りて深謝の意を表します.
本稿の執筆にあたり,情報処理学会 理事(技術応用担当)斎藤彰宏氏より有益なご助言をいただきました.ここに記して謝意を表します.
参考文献
- 1)経済産業省:デジタルガバナンス・コード2.0,https://www.meti.go.jp/policy/it_policy/investment/dgc/dgc2.pdf(2026年2月アクセス).
- 2)(独)情報処理推進機構:DX動向2025,https://www.ipa.go.jp/digital/chousa/dx-trend/tbl5kb0000001mn2-att/dx-trend-2025.pdf(2026年2月アクセス).
- 3)(一社)データサイエンティスト協会:データサイエンティストの就労意識~2015→2024 一般(個人)会員アンケートより,https://speakerdeck.com/datascientistsociety/person_research2024(2026年2月アクセス).
- 4)アシストソリューション研究会 2024年度 ビジネスに貢献するデータ活用分科会:データ利活用トレーニングブック,https://www.ashisuto.co.jp/solution-studygroup/assets/pdf/workgroups/report/2024data_e_book.zip(2026年2月アクセス).
- 5)(独)情報処理推進機構:デジタル時代のスキル変革等に関する調査(2024年度)全体報告書,https://www.ipa.go.jp/jinzai/chousa/tbl5kb000000a7iv-att/skill-henkaku2024-zentai.pdf(2026年2月アクセス).
佐藤洋輔
yosuke@inet.jeis.co.jp
(株)JR東日本情報システム.1987年生まれ.2009年に入社し,鉄道事業者向けシステムの開発・運用業務に従事.現在はマネージャーとして各種案件の推進に加え,組織運営を担当.
梅本典明
umemotonoriaki@gmail.com
(株)ジェーシービー.1986年生まれ.2025年に入社しシステム企画部戦略グループ所属.社内の生成AI利活用推進を担当.
江﨑真代
ezaki.mayo@canon-its.co.jp
キヤノンITソリューションズ(株).1999年生まれ.2022年に入社後,直販営業として1年半DXソリューションの提案に従事.現在はパートナー営業としてローコードソリューションの提案・拡販を担当.
後藤真李
mgoto@ashisuto.co.jp
(株)アシスト.1994年生まれ.2017年に入社後,エンドポイントセキュリティ製品の専任技術者として提案・構築業務に従事.その後,製品マーケティング部に異動し,セキュリティ製品全般のプロモーション業務を担当.
小峯大地
daichi.komine@tisi.jp
TISI(株).1999年生まれ.2022年に入社後,製造事業者向けデータ活用基盤構築支援および設計・開発に従事.現在は運輸事業者向け管理会計システムの設計・開発を担当.
佐谷果音
kanon_satani@shimz.co.jp
清水建設(株).1998年生まれ.2021年に入社後,営業系システムの開発グループにて2年間プロジェクトに参画.その後,データ利活用推進グループにてデータ基盤の構築,各部門の取り組み支援,データ利活用人材の育成などに従事.現在は,支店の運営戦略の立案・推進と情報化推進を担当.
軸丸恵梨
ejikumaru@ashisuto.co.jp
(株)アシスト.1979年生まれ.データ活用製品のプリ/ポストセールス,研修,顧客支援を幅広く担当.近年は製品価値と顧客満足度の向上に向けて,サービス企画・推進,情報発信,ナレッジ基盤整備も担当.
採録決定:2026年4月9日
編集担当:斎藤彰宏(日本アイ・ビー・エム(株))