自然言語からの最適化モデル自動構築と自己修正
※本稿の著作権は,日本アイ・ビー・エム(株)に帰属します.
1.はじめに
数理最適化は,限られた資源の中で最適な意思決定を支援する強力な手法であり,製造業,物流,人員配置など多様な分野で重要な役割を果たしている.特に,複雑な制約条件下で最適な解を導くためのモデル構築は,業務効率化やコスト削減に直結するため,実務上の価値が高い.
しかし,数理最適化の現場導入には多くの課題が伴う.最大の障壁の1つは,業務に内在する複雑な制約やルールを数理的に定式化するプロセスである.これは,現場担当者が直感的に理解している業務知識を抽象化し,数式や論理式として表現する作業であり,高度な専門性が求められる.さらに,最適化モデルの構築には,Pyomo[1]やDOcplex Python API [2]などのモデリング言語への習熟が不可欠であり,数理最適化には,プログラミングスキルと数理的素養の両方が必要となる.
モデルにおいても,実行結果が期待どおりにならない場合には,制約条件や変数定義の見直しが必要となり,試行錯誤を伴う検証・修正のプロセスが発生する.
このように,数理最適化の導入には,業務知識と数理的表現の橋渡し,モデリング言語の習得,そして継続的な検証・改善といったスキルが求められる.
本研究では,大規模言語モデル(以下,LLM)を活用し,業務文書から最適化モデルを自動生成し,検証・修正までを一貫して自動化する手法を提案する.提案手法では,LLMが業務要件を記述した自然言語文から変数および制約を抽出し,IBM ILOG CPLEXの最適化モデルを構築する.さらに,実行結果に基づいてLLMがエラー検出と修正を繰り返すことで,モデル構築における反復的な検証作業を削減し,構築プロセスの効率化および構築時間の大幅な短縮を実現する.
提案手法の有効性を評価するため,線形計画,混合整数計画,二次計画,割当問題,およびスケジューリング問題に対して自動構築および自己修正機能を適用し,生成されたモデルの正解率および構築時間を測定した.
2.関連研究
IBM Decision Optimizationに実装されたModeling Assistant[3]は,自然言語でモデルを作成することができる.入力データに基づいて変数や制約を提案し,最適化モデルの構築を支援する機能を提供している.しかし,この技術は標準的な問題領域(スケジューリング,資源配分など)に限定されており,複雑な業務固有の制約や非定型な問題には対応が困難である.また,制約の追加やデータ前処理には依然としてPythonコードの記述が必要である.
近年は大規模言語モデル(LLM)の進化により,自然言語での対話を通じて最適化モデルを自動構築する試みが数多く報告されている.Wasserkrugら[4]は,LLMとオペレーションズ・リサーチ(OR)の数理最適化を統合し,専門知識がなくても組織の意思決定者が複雑な最適化問題を解ける「Decision Optimization CoPilot(DOCP)」の構想を提示している.ただし,実験対象は混合整数計画(MILP)に限られており,評価も人手による妥当性確認にとどまっている.
Astorgaら[5]は,LLMと探索アルゴリズムを組み合わせた「Autoformulation」により,線形・混合整数問題の自動構築を実現した.しかし,モデルの妥当性評価や業務文書との整合性確認には対応していない.
Szeiderら[6]は,LLMと制約プログラミングを統合したMCP-Solverを提案し,自然言語から形式的な制約モデルへの変換を可能にした.ただし,実行結果に基づくモデル修正や業務文書との照合は対象外である.
Ramamonjisonら[7]は,ユーザーが自然言語で記述した問題文から目的関数や制約式を含む最適化モデルを生成するシステム「OptGen」を提案した.2段階のマッピングとプロンプト誘導型生成により未知の領域でも高精度な定式化を実現し,LPを対象に新規データセットを用いた評価を行った.ただし,検証は定式化の精度(目的関数や制約式の一致度)に限定され,実行可能なコードの生成は実施されていない.
Liuら[8]は,自然言語で記述された最適化課題を定式化からコード生成・求解・説明まで一気通貫で支援する枠組み「OptLLM」を提案した.対話を通じて不足情報を補い,LPおよびMILPを対象に評価を行っている.ただし,評価指標は数式レベルでの完全一致に限定され,ソルバによる解の品質や実行後の修正過程は対象外である.
これらの研究は,最適化モデルの自動化に向けた重要な知見を提供しているが,業務文書との整合性確認,実行結果に基づく自動修正,最適化コードの自動生成と自動実行といった業務導入上の主要課題を包括的に解決するものは存在せず,実務での信頼性確保には課題が残されている.
本研究は,これらの課題を包括的に解決し,自然言語を入力するだけで最適化を実行可能とするフレームワークを提案する.
3.提案手法
本研究では,業務文書に記述された自然言語の情報から,数理最適化モデルを自動的に構築・検証・修正するためのアプローチを提案する.この手法は,LLMによる自然言語理解と,LangGraphによる処理フローの制御を組み合わせることで,従来手動で行われていたモデリング作業を大幅に効率化・自動化することを目指している.
LangGraphは,LLMの出力を状態遷移グラフとして管理できるフレームワークであり,各処理ステップをノードとして定義し,条件に応じて分岐・ループ・再試行などの制御を柔軟に設計できる.これにより,自然言語から最適化モデルを生成し,実行結果に応じて自律的に検証・修正を行う一連のプロセスを,論理的かつ再現性のある形で構築することができる.
具体的には,業務文書から変数・制約・目的関数などの構成要素を抽出し,DOcplex Python APIによる最適化モデルコードを生成する.生成されたコードはCPLEXにより実行され,結果が妥当であれば処理を完了し,実行エラーや結果に業務文書との不整合が検出される場合にはLangGraphの制御により修正フローへと遷移する.修正はLLMによって局所的に行われ,再実行・再評価を繰り返すことで,モデルの品質と業務文書との整合性を高めていく.
このような構成により,業務知識を活用した最適化モデルの迅速な構築と,実運用に耐え得る品質の確保が可能となる.
3.1 状態遷移グラフ
図1に本システムの構成を示す.各ノードは以下のような役割を持つ:
- __start__:ワークフローの開始点.業務文書の入力と初期化を行う.
- generate_code:LLMを用いて業務文書から最適化に必要な情報(変数,制約,目的関数)を抽出し,DOcplex Python APIを用いた初期コードを生成する.
- execute_code:生成されたコードを実行し,最適化エンジンによって解を得る.
- check_result:実行結果の妥当性を評価し,業務文書との矛盾の有無を確認する.
- retry:試行回数の管理を行い,必要に応じて修正プロセスへ分岐させる.
- fix_issue:業務文書と実行結果との矛盾や実行エラーに対して,LLMを用いて前回のコードに局所的な修正を行う.
- __end__:処理が正常に完了した場合に遷移する終了ノード.
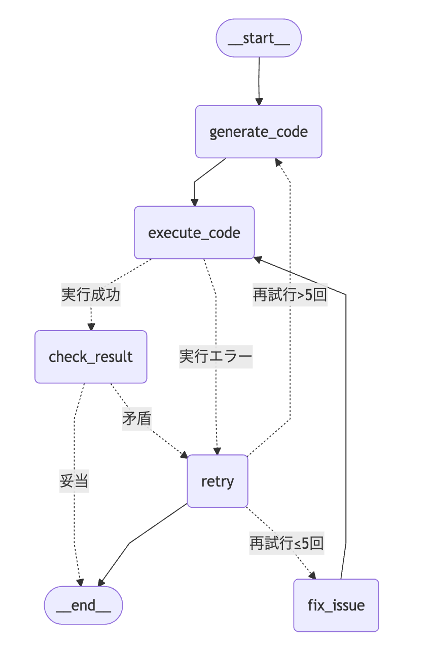
処理は,__start__ノードから始まり,業務文書などの自然言語文書が入力され,LLMがgenerate_codeノードにて数理最適化モデルのコードを生成する.生成されたコードはexecute_codeノードで実行され,最適化エンジンによって求解される.
実行結果が得られた場合はcheck_resultノードに進み,結果と業務文書との整合性が評価され,問題がなければ__end__ノードに遷移して処理は完了する.一方,結果に不整合がある場合はretryノードを経由してfix_issueノードに進み,修正処理が行われる.修正後は再びexecute_codeに戻り,再実行と再評価が行われる.なお,コードの実行時にエラーが発生した場合には,check_resultを経由せず直接retryノードに遷移し,同様にfix_issueによる修正が行われる.
ここで,各コード生成に対する修正回数の上限は5回とする.修正回数が5回に達しても妥当な解が得られない場合,初回生成コードに根本的な誤りがあるとみなし,generate_codeノードに戻ってコードを再生成する.コード再生成の上限回数は5回とした.
4.実験
4.1 実験概要
提案手法の有効性を検証するために,自然言語で記述された業務文書から最適化結果を得るタスクを実行する.この業務文書は,数式を含まない自然文として与えられ,業務上の最適化問題を記述している.この文書からDOcplex Python APIを使った数理最適化モデルを自動生成し,検証・修正までを一貫して行う.CPLEXにはMathematical Programming(MP)とConstraint Programming(CP)の2種類の最適化エンジンが備わっている.MPエンジンは線形計画法(LP),混合整数計画法(MIP),二次計画法(QP)など目的関数と制約条件が数式で明確に定義できる問題群を解くために使用する.このような問題群を本稿では定式化可能最適問題と呼ぶ.一方,CPエンジンは複雑な論理・順序・関係性に基づく制約を持ち,目的関数がなくても成立する問題群を解くために使用する.このような問題群を本稿では探索型組合せ問題と呼ぶ.どちらのエンジンを使って解ける問題もあるので,どちらを使って解くかは利用者が決める想定である.
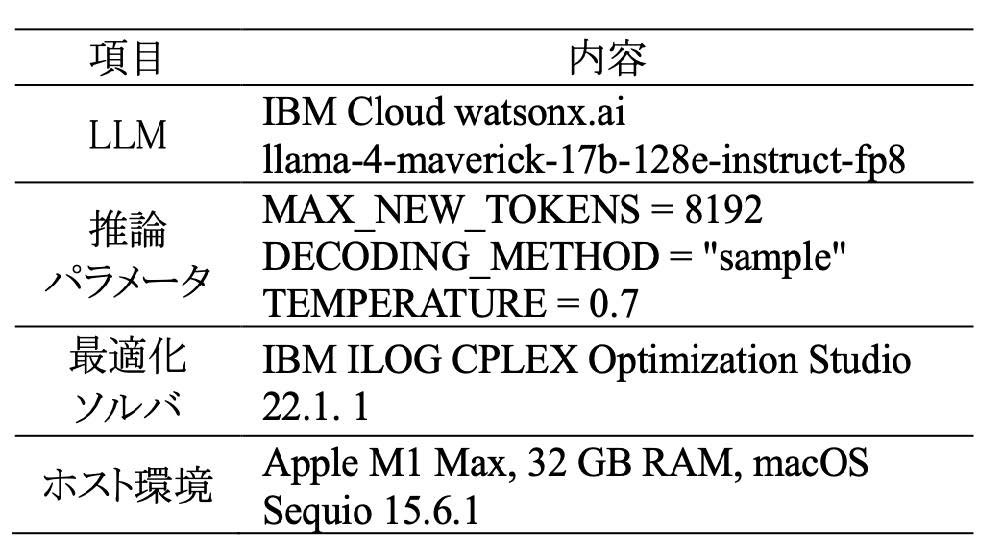
本実験では,各問題について10回の生成試行を行い,正答率と平均実行時間を計測した.表1に,本実験の実行環境を示す.
4.2 数理最適化問題
提案手法が最適化問題に対して正しい解を導けるかを検証するため,本研究では数理計画問題であるLP,MILP,QP,割当問題,スケジューリング問題を対象に実験を行った.これらはいずれも代表的な数理最適化問題である.
本実験では,LP 6問,MILP 6問,QP 2問,割当問題 2問,スケジューリング問題 5問に対して提案手法を実行し,評価を行った.LP,MILP,QPの各問題はDOcplex Python APIの公式ドキュメント[2]から5問を引用し,7問を新たに作成した.割当問題とスケジューリング問題は公式ドキュメント[2]から引用した.業務文書として与えられるプロンプトは付録に記したGithubにて公開している.
4.2.1 定式化可能最適化問題
MPエンジンで解くことのできるLP,MILP,QPの問題の概要を述べる.
LPの一般式は以下で表される.
\[\min_{x \in \mathbb{R}^n} \enspace c^{\mathrm{T}} x \enspace \text{s.t.} \enspace Ax \leq b,\enspace x \geq 0\]
ここで,\(c \in \mathbb{R}^n\) は与えられた目的関数の係数ベクトル,\(A\in\mathbb{R}^{m\times n}\),\(b\in\mathbb{R}^m\)は与えられた制約条件,\(n\)は変数の数,\(m\)は制約の数を表す.LPは生産計画や輸送計画などの業務課題を解決できる.
MILPの一般式は以下である.
\[\min_{x \in \mathbb{R}^n} \enspace c^{\mathrm{T}} x \enspace \text{s.t.} \enspace Ax \leq b,\enspace x \geq 0,\enspace x_i \in \mathbb{Z}\ \text{for some}\ i\]
LPと同様に,\(c\in\mathbb{R}^n\)は与えられた目的関数の係数ベクトル,\(A\in\mathbb{R}^{m\times n}\),\(b\in\mathbb{R}^m\)は与えられた制約条件,\(n\)は変数の数,\(m\)は制約の数を表し,\(i\in\left\{1,\ldots,n\right\}\)である.MILPはLPに整数制約(特に0-1変数など)を加えたもので,たとえば「ある設備を使うか使わないか」「あるルートを選ぶか選ばないか」などの離散的な意思決定を含む問題を解決できる.
QPの一般式は以下である.
\[\min_{x \in \mathbb{R}^n} \enspace \frac{1}{2}x^{\mathrm{T}}Qx + c^{\mathrm{T}} x \enspace \text{s.t.} \enspace Ax \leq b,\enspace x \geq 0\]
LP,QPと同様に,\(c\in\mathbb{R}^n\)は与えられた目的関数の係数ベクトル,\(A\in\mathbb{R}^{m\times n}\),\(b\in\mathbb{R}^m\)は与えられた制約条件,\(n\)は変数の数,\(m\)は制約の数を表す.ここで,\(Q\in\mathbb{R}^{n\times n}\)は対称行列であり,通常は問題が凸となるよう半正定値行列として与えられる.QPはポートフォリオ最適化や制御問題など,目的関数が二次形式となる問題を解決できる.
一般に,LLMは入力トークン数が増加すると推論精度が低下することが知られており[9],プロンプトが長大になる問題では解答精度が下がることが予想される.また,変数や制約の数が増えるほど,モデルがCPLEX記法に基づいて正確なコードを生成することが難しくなる傾向があると予想される.このような理由から,問題の複雑さを定量的に評価するための指標として,入力トークン数,変数の数,制約の数を用いる.
4.2.2 探索型組合せ問題
CPエンジンは,組合せ最適化問題に用いられ,特に割当問題やスケジューリング問題に対して有効である.割当問題には,ナップサック問題や部屋割り問題などが含まれ,スケジューリング問題は,時間割編成や作業スケジュールの最適化を対象とし,切り替え時間や作業順序などの複雑な論理制約を伴うことが多い.
CPエンジンでは,これらの制約を記述・処理するために多数の専用APIが提供されており,論理制約の種類に応じて適切なAPIを選択する必要がある.MPエンジンのモデルコードが数式と直接対応する形式で記述されるのに対し,CPエンジンでは論理制約の種類ごとに異なるAPIを呼び出す必要があるため,より構造的・論理的な記述が求められる.
探索型組合せ問題の複雑さを定量的に評価するための指標として,入力トークン数,変数の数,制約の数に加え,目的関数の有無および使用するAPIの種類数を用いる.
4.3 実験結果
4.3.1 定式化可能最適化問題の実験結果
定式化可能最適化問題の実験結果を表2に示す.問題列には各問題クラスの問題番号,正答率列には10回の実験において提案手法が正しい最適化結果を出力した正答率を記載している.また,平均実行時間列には正答した結果のみの平均実行時間を記載した.
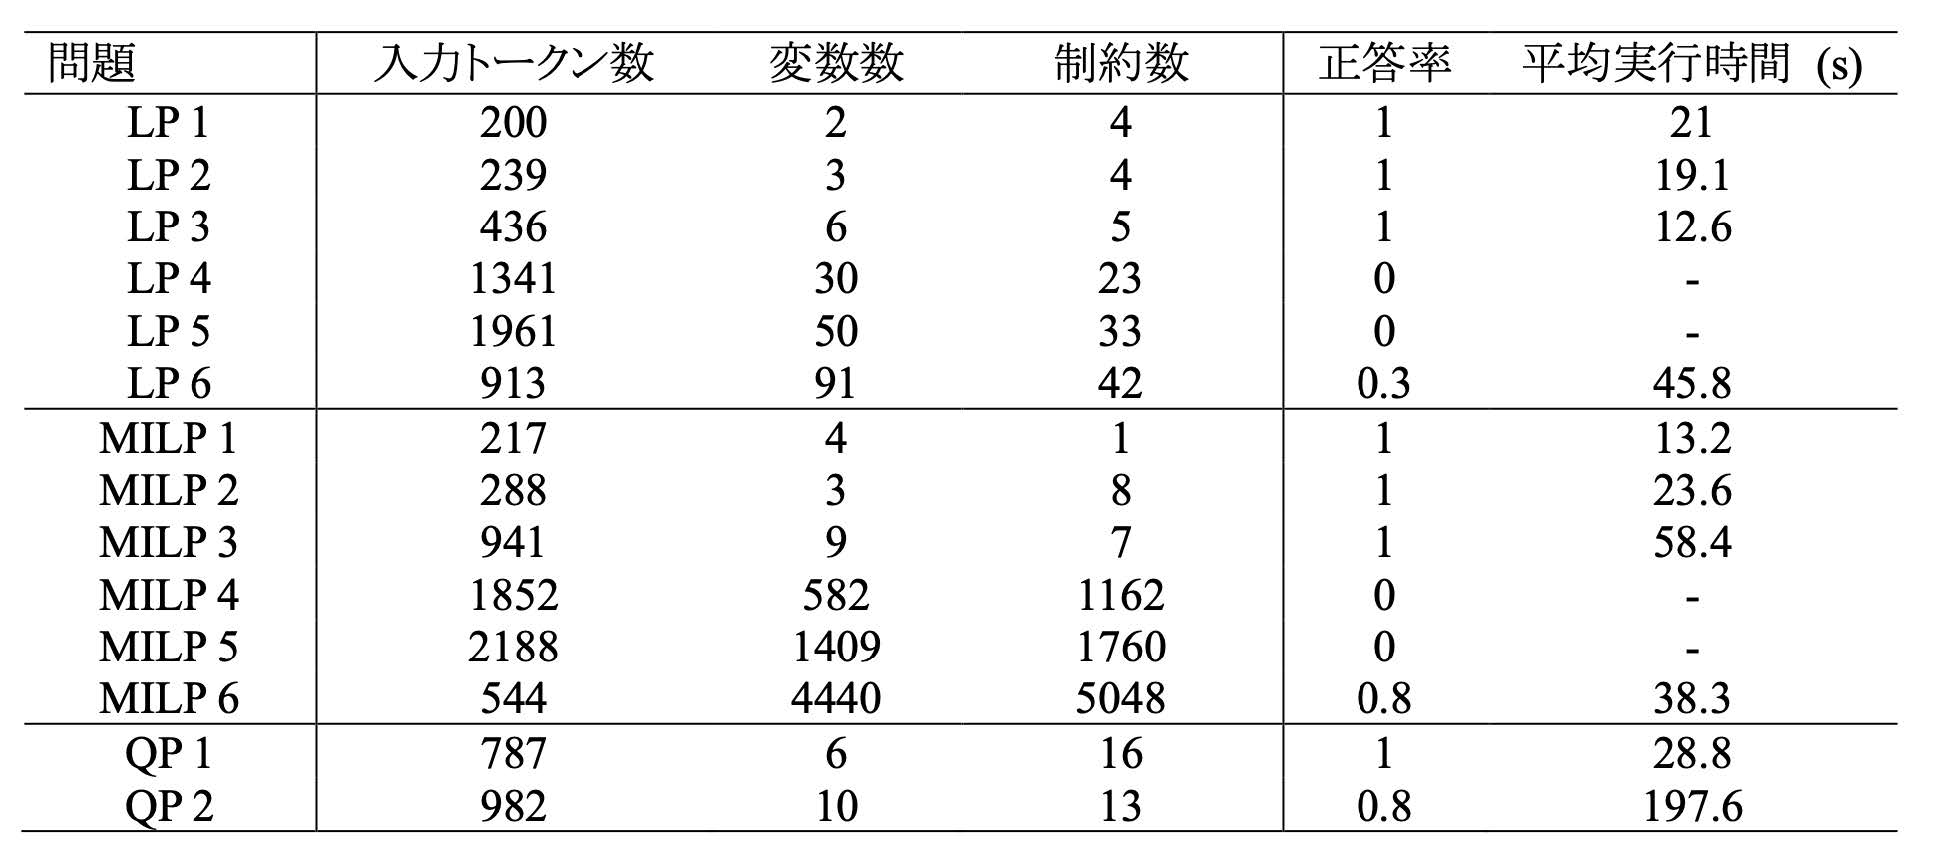
表2から,小規模な数理計画問題では提案手法が安定して高い正答率を達成したことが分かる.具体的には,LP1〜LP3およびMILP1〜MILP3,QP1は入力トークン数が1,000未満,変数数と制約数がともに高々16であり,いずれも100%の正答率を示した.これらの問題では平均実行時間も20〜60秒程度に収まり,LLMによるコード生成と実行検証が円滑に行えることが確認できた.
一方,入力トークン数が1,000を超え,変数数と制約数が2桁から3桁を超える規模に増えると精度が急激に低下した.LP4とLP5は全試行で一度も回答を生成することなくグラフの状態遷移が終了し,LP6は主に制約条件の抽出誤りにより正答率が0.3にとどまった.MILPにおいても,MILP4およびMILP5は一度も回答が生成されることなくグラフの状態遷移が終了した.このことから,プロンプトが長大になりモデル構造が複雑化すると,LLMが正しいCPLEXコードを出力する能力が著しく低下することが明らかになった.
ただし,すべての大規模問題が失敗するわけではない.スポーツスケジューリングを模したMILP6はトークン数544と短い文章で記述されているものの,変数数は4,440,制約数5,048に及ぶ.それにもかかわらず成功率は0.8と比較的高く,平均実行時間も38.3秒と大きい部類ではなかった.これは,入力文が短い場合や制約構造が定型化されている場合には,変数や制約数が多い場合でも一定の精度でコード生成・検証が可能であることを示す.
総じて,数理計画問題の実験においては「入力トークン数」と「変数・制約数」の両方が精度を左右する主因であり,特に入力トークン数が長大化すると正答率が大きく低下することが分かった.
4.3.2 探索型組合せ問題の実験結果
表3に示した探索型組合せ問題に関する実験結果から,問題規模と正答率・計算時間との関係について以下のような知見が得られた.
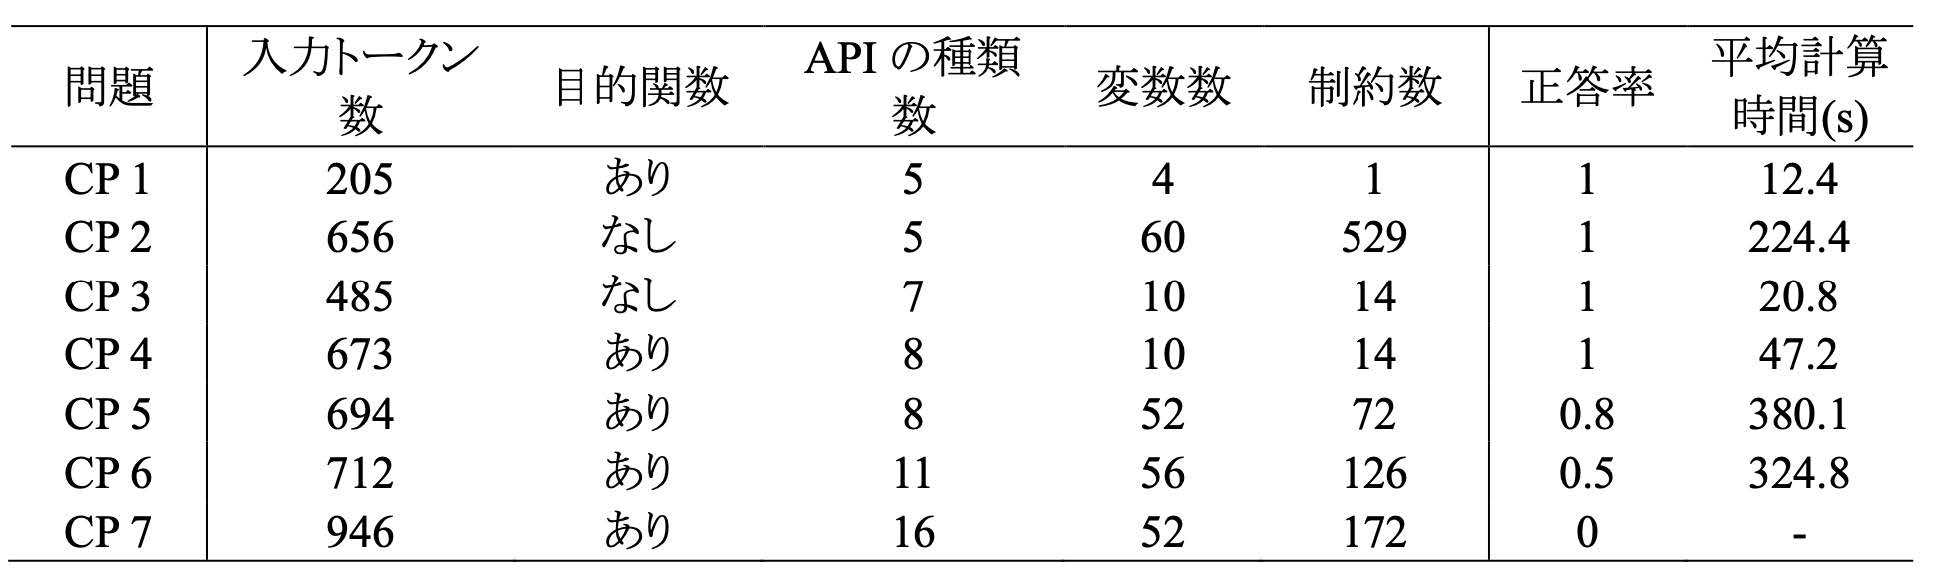
まず,CP1〜CP4の比較的規模の小さい問題に対しては,全試行において正答が得られており,安定した性能が確認された.これらの問題は以下のとおりである:
- CP1:0-1ナップサック問題(選択型最適化)
- CP2:部屋割り問題(制約充足型)
- CP3:住宅建設工程の順序決定(制約充足型)
- CP4:住宅建設工程の順序決定(目的関数あり)
これらの問題では,入力トークン数・制約数・変数数が比較的少なく,計算時間も短時間(12〜47秒)で済んでいる.
一方,CP5〜CP7では問題規模の増加に伴い,正答率の低下および計算時間の増加が顕著に見られた.各問題の特徴は以下のとおりである:
- CP5:作業者の移動に伴う切り替え時間を考慮するスケジューリング問題
- CP6:現金残高制約を含むスケジューリング問題(資金がなければ作業開始不可)
- CP7:作業者の休暇による作業中断を含むスケジューリング問題(休暇情報の表が大きく,入力トークン数が増加)
特にCP7では,業務文書中に含まれる休暇情報の表が大規模であったため,入力トークン数が増加し,全試行が失敗に終わった.これは,LLMの処理能力の限界を示唆している.
以上の結果から,探索型組合せ問題においては,問題規模(特に制約数・変数数・入力トークン数)がモデル生成の性能に影響することが示唆された.この問題への対応策としては,入力を簡素化してトークン数を抑えることや,より多くのトークンを処理できる大規模なLLMを導入することが,複雑な制約を含む問題への対処に有効である.
5.おわりに
本研究では,自然言語で記述された業務文書から最適化モデルを自動生成し,検証・修正までを一貫して行う手法を提案した.提案手法により,従来は専門的知識を要したモデリング作業の一部を自動化し,最適化コードの構築に要する時間を短縮できる可能性を示した.
実験では,数理計画問題およびスケジューリング問題を対象に検証を行い,問題の種類によって構築の成功率や実行時間に差異が生じることを確認した.特に,入力トークン数が大きい場合や,変数と制約の総数が大規模になる場合に,生成されるコードの精度が低下する傾向が見られた.一方,比較的規模の小さい問題では安定して最適化コードが生成され,提案手法の有効性が示された.
ただし,提案手法は完全な自動保証を行うものではなく,誤った制約や結果を排除しきれない場合も存在する.そのため最終的な確認には依然として専門家の知識が必要であり,非専門家による直接利用は今後の課題として残されている.
さらなる今後の課題としては,より高性能なLLMの利用や,生成結果の検証を部分的に自動化する仕組みの導入が挙げられる.さらに,IBMが公開するOSS Doclingを利用することで,ExcelやPDFといった業務文書をそのまま入力として扱える可能性があり,非構造的な業務情報から最適化モデルを直接構築する自動化が期待される.これらにより,将来的には専門家だけでなく非専門家も容易に最適化を活用できる環境の実現を目指すことができる.
本研究は,数理最適化導入に伴う定式化やモデリングの負担を軽減し,AIと数理最適化の融合による業務支援の可能性を示すものである.今後,課題に取り組むことで,より幅広い応用と実用化が進み,多様な業務分野において効率化と意思決定支援に貢献することが期待される.
参考文献
- 1)Bynum, M. L. et al.: Pyomo - Optimization Modeling in Python (3rd ed.), Springer (2021).
- 2)IBM Decision Optimization CPLEX Modeling for Python: https://ibmdecisionoptimization.github.io/docplex-doc/(2025/8/10参照).
- 3)Decision Optimization Modeling Assistant models: https://www.ibm.com/docs/ja/watsonx/saas?topic=experiments-modeling-assistant-models(2025/8/10参照).
- 4)Wasserkrug, S. et al.: Enhancing Decision Making through the Integration of Large Language Models and Operations Research Optimization, Proceedings of the AAAI Conference on Artificial Intelligence, Vol.3, Issue 27, pp.28643-28650 (2024).
- 5)Astorga et al.: Autoformulation of Mathematical Optimization Models Using LLMs, ICML 2025, arXiv:2411.01679 (2025).
- 6)Szeider, S.: MCP-Solver: Integrating Language Models with Constraint Programming Systems, arXiv:2501.00539 (2024).
- 7)Ramamonison, R. et al.: Augmenting Operations Research with Auto-Formulation of Optimization Models, EMNLP 2022, arXiv:2209.15565 (2022).
- 8)Liu, Z. et al.: Solving General Natural-Language-Description Optimization Problems with Large Language Models, arXiv:2407.07924.
- 9)Context Rot: How Increasing Input tokens Impacts LLM Performance, https://research.trychroma.com/context-rot(2025/9/29参照).
付録
本実験で用いたソースコードとデータセットは,以下のGithubにて閲覧可能である.
https://github.ibm.com/xiaomou-hou/ibm-technical-paper-2025
永里和哉
Kazuya.Nagasato@ibm.com
2023年東京工業大学情報理工学院数理・計算科学系修了.同年日本アイ・ビー・エム(株)入社.現職はテクノロジー事業本部に在籍し,データサイエンティストとして生成AIや数理最適化を中心としたAIソリューションの設計・導入を担当.
侯 驍謀
xiaomou.hou@ibm.com
2023年東京大学大学院新領域創成科学研究科複雑理工学専攻修了.2024年日本アイ・ビー・エム(株)に入社.データサイエンティストとして生成AIソリューションの開発に従事.
阪本正治
sakamoto@jp.ibm.com
1989年電気通信大学大学院電気通信学研究科通信工学専攻修士課程修了.同年,日本アイ・ビー・エム(株)東京基礎研究所に入所し,音声合成・音声認識,並列ソフトウェア,半導体リソグラフィー最適化などの研究開発に従事.2018年よりExpert Labsにて,データサイエンティストとして生成AIソリューションおよび数理最適化プロジェクトに携わる.2000年,東京大学より数理科学博士号を取得.IEEE シニアメンバー.
採録決定:2026年4月15日
編集担当:斎藤彰宏(日本アイ・ビー・エム(株))