生成AIを用いた設計書レビュー支援のための図表解釈精度評価
※本稿の著作権は,著者に帰属します.
1.設計書レビューの課題と生成AIによる支援の必要性
当社は大規模かつ多領域のシステム開発を担い,開発要員が作成する成果物のレビューを通じて品質を確保してきた.その中でも,要件を実装へと橋渡しする設計工程は,後続の製造・テスト工程における手戻り抑制や不具合発生リスクの低減,さらにはサービスイン後の安定稼働に直結する中核工程であり,設計書レビューが有識者の工数に大きく依存している状況である.一方でビジネス環境の急速な変化により,システムは複数ドメイン化・複雑化し,個々の案件には短いリリースサイクルと高品質が同時に求められる状況の中,有識者にレビューが集中しがちな従来のプロセスは,プロジェクト規模の拡大とともにボトルネックとなりつつある.特に,レビュー資料の事前読み込みや観点の洗い出し,軽微な記述不備の指摘といった付帯作業が,有識者の稼働を圧迫している点は看過できない.
こうした背景から,設計書レビューの一部を生成AIにより支援し,効率化を図ることが必要である.LLMの発展によりテキストベースの設計記述に対する解析や要約は比較的容易になりつつある.一方で,当社の既存の設計書はOffice形式のドキュメントを中心に,業務・処理の流れを図式化したフロー図(以降,業務フロー図と呼ぶ)やシーケンス図やクラス図など多数の図表を含んでおり,これら非テキスト情報をどこまで生成AIで扱えるかが生産性向上の鍵である.
近年,画像や図表を直接入力として扱えるマルチモーダルLLMが登場し,既存の設計書をそのまま対象とした解析・レビュー支援の可能性が広がりつつある.また,Mermaidに代表されるDSL(Domain-Specific Language:ドメイン特化言語)とMarkdownを用いてドキュメントを整備し,LLMと協調的に設計・実装を進める手法の有効性も示されている.しかし,当社が保有する設計書の規模は大きく,短期間で一括してDSLベースへ移行することは,現時点では投資対効果の見通しが立てにくく,初手の選択肢としては現実的とは言い難い.
そこで本研究では,既存の設計書に含まれる図表に対してマルチモーダルLLMを適用し,その構造理解・意味理解・レビュー支援の観点から挙動を段階的に検証するとともに,同一内容をMermaidに変換した場合との比較を行う.具体的には,以下3点を明らかにすることを目的とする.
- 図表に対して生成AI(マルチモーダルLLM)を適用した場合,設計書レビューをどの程度まで支援できるかを検証する
- 画像入力とDSL/Mermaid入力の性質の違いを比較し,その特徴を整理する
- 両者の結果を踏まえ,現実的な活用方法とその限界を明らかにする
2.生成AIによる設計書レビュー支援の実現性評価の段階
設計書レビューに生成AIを適用する際には,「図表をどの程度正しく解釈できるか」と「解釈した内容をどこまでレビュー指摘に結びつけられるか」という段階が存在する.本研究ではこの2段階を踏まえ,生成AIの活用可能性を次の3つの観点から段階的に評価する.
- 構造理解の観点
図表の構造をどこまで正しく抽出できているかを確認する.
- 意味理解の観点
抽出した構造から業務ロジックの振舞いをどこまで把握できているかを確認する.
- レビュー支援の観点
実際のレビュー指摘としてどのような内容を出力させることができるかを確認する.
本研究では,これらの観点を次の3段階の検証プロセスとして実施する.
- 第1段階 図表の構造理解が相対的に得意なモデルの抽出
- 第2段階 意味理解度の確認及びプロンプト設計
- 第3段階 レビュー支援の観点の評価
構造理解の観点に対応し,業務フロー図およびCRUD表を入力とした場合に,図表要素(ノード・矢印・セルなど)とそれらの関係性をどの程度正しく抽出できるかを確認する.ここでは,生成AIとしてマルチモーダルLLMのGPT[1]・Claude[2]・Gemini[3]を対象とし,同一の図表セットを与えて要素列挙・関係列挙を行わせ,その結果を人手で作成した正解データと比較することで,構造理解が相対的に得意なモデルを抽出する.
意味理解の観点に対応し,第1段階で選定した生成AIを用いて,業務フロー図から抽出した構造から業務フローをどこまで把握できているかを確認する.また,生成AI内部での業務フローの理解度の向上に寄与するプロンプト設計を検討し,Mermaidによる業務フロー定義を入力とした場合との意味理解度を比較する.
レビュー支援の観点に対応し,第1段階で選定した生成AIを用いて,画像として与えた業務フロー図と,Mermaidにより記述したフロー定義との比較を通じて,生成AIの活用可能性を検討する.具体的には,入力として業務フロー図を与える場合と,同一内容をMermaidで表現したテキストベースのフロー定義を入力とする場合とで,混入させたバグ(フローの誤り)を指摘させるタスクを与え,その応答内容と混入バグとが一致しているかを確認する.これにより,既存のOffice文書に含まれる業務フロー図を生成AIで直接扱う場合と,Mermaidによる構造化表現に変換した上で生成AIを適用する場合との間で,レビュー支援としてどの範囲まで期待できるか,またどのような使い分けが現実的かを検討する.
3.評価手順
本研究では,第2章で述べた観点──構造理解の観点・意味理解の観点・レビュー支援の観点──に対応する3段階のタスクを設定し,生成AIによる設計書レビュー支援の実現性を評価する.本章では,評価対象となる図表と生成AIのバリエーション,ならびに評価手順について述べる.
3.1 構造理解の観点の評価手順
業務フロー図およびCRUD表から,図表要素とそれらの関係性をどの程度正しく抽出できるかを確認する.具体的には以下の手順で評価を行った.
- 生成AIへの図表の入力
- 生成AIへの応答フォーマットの指定
- 正解データとの比較
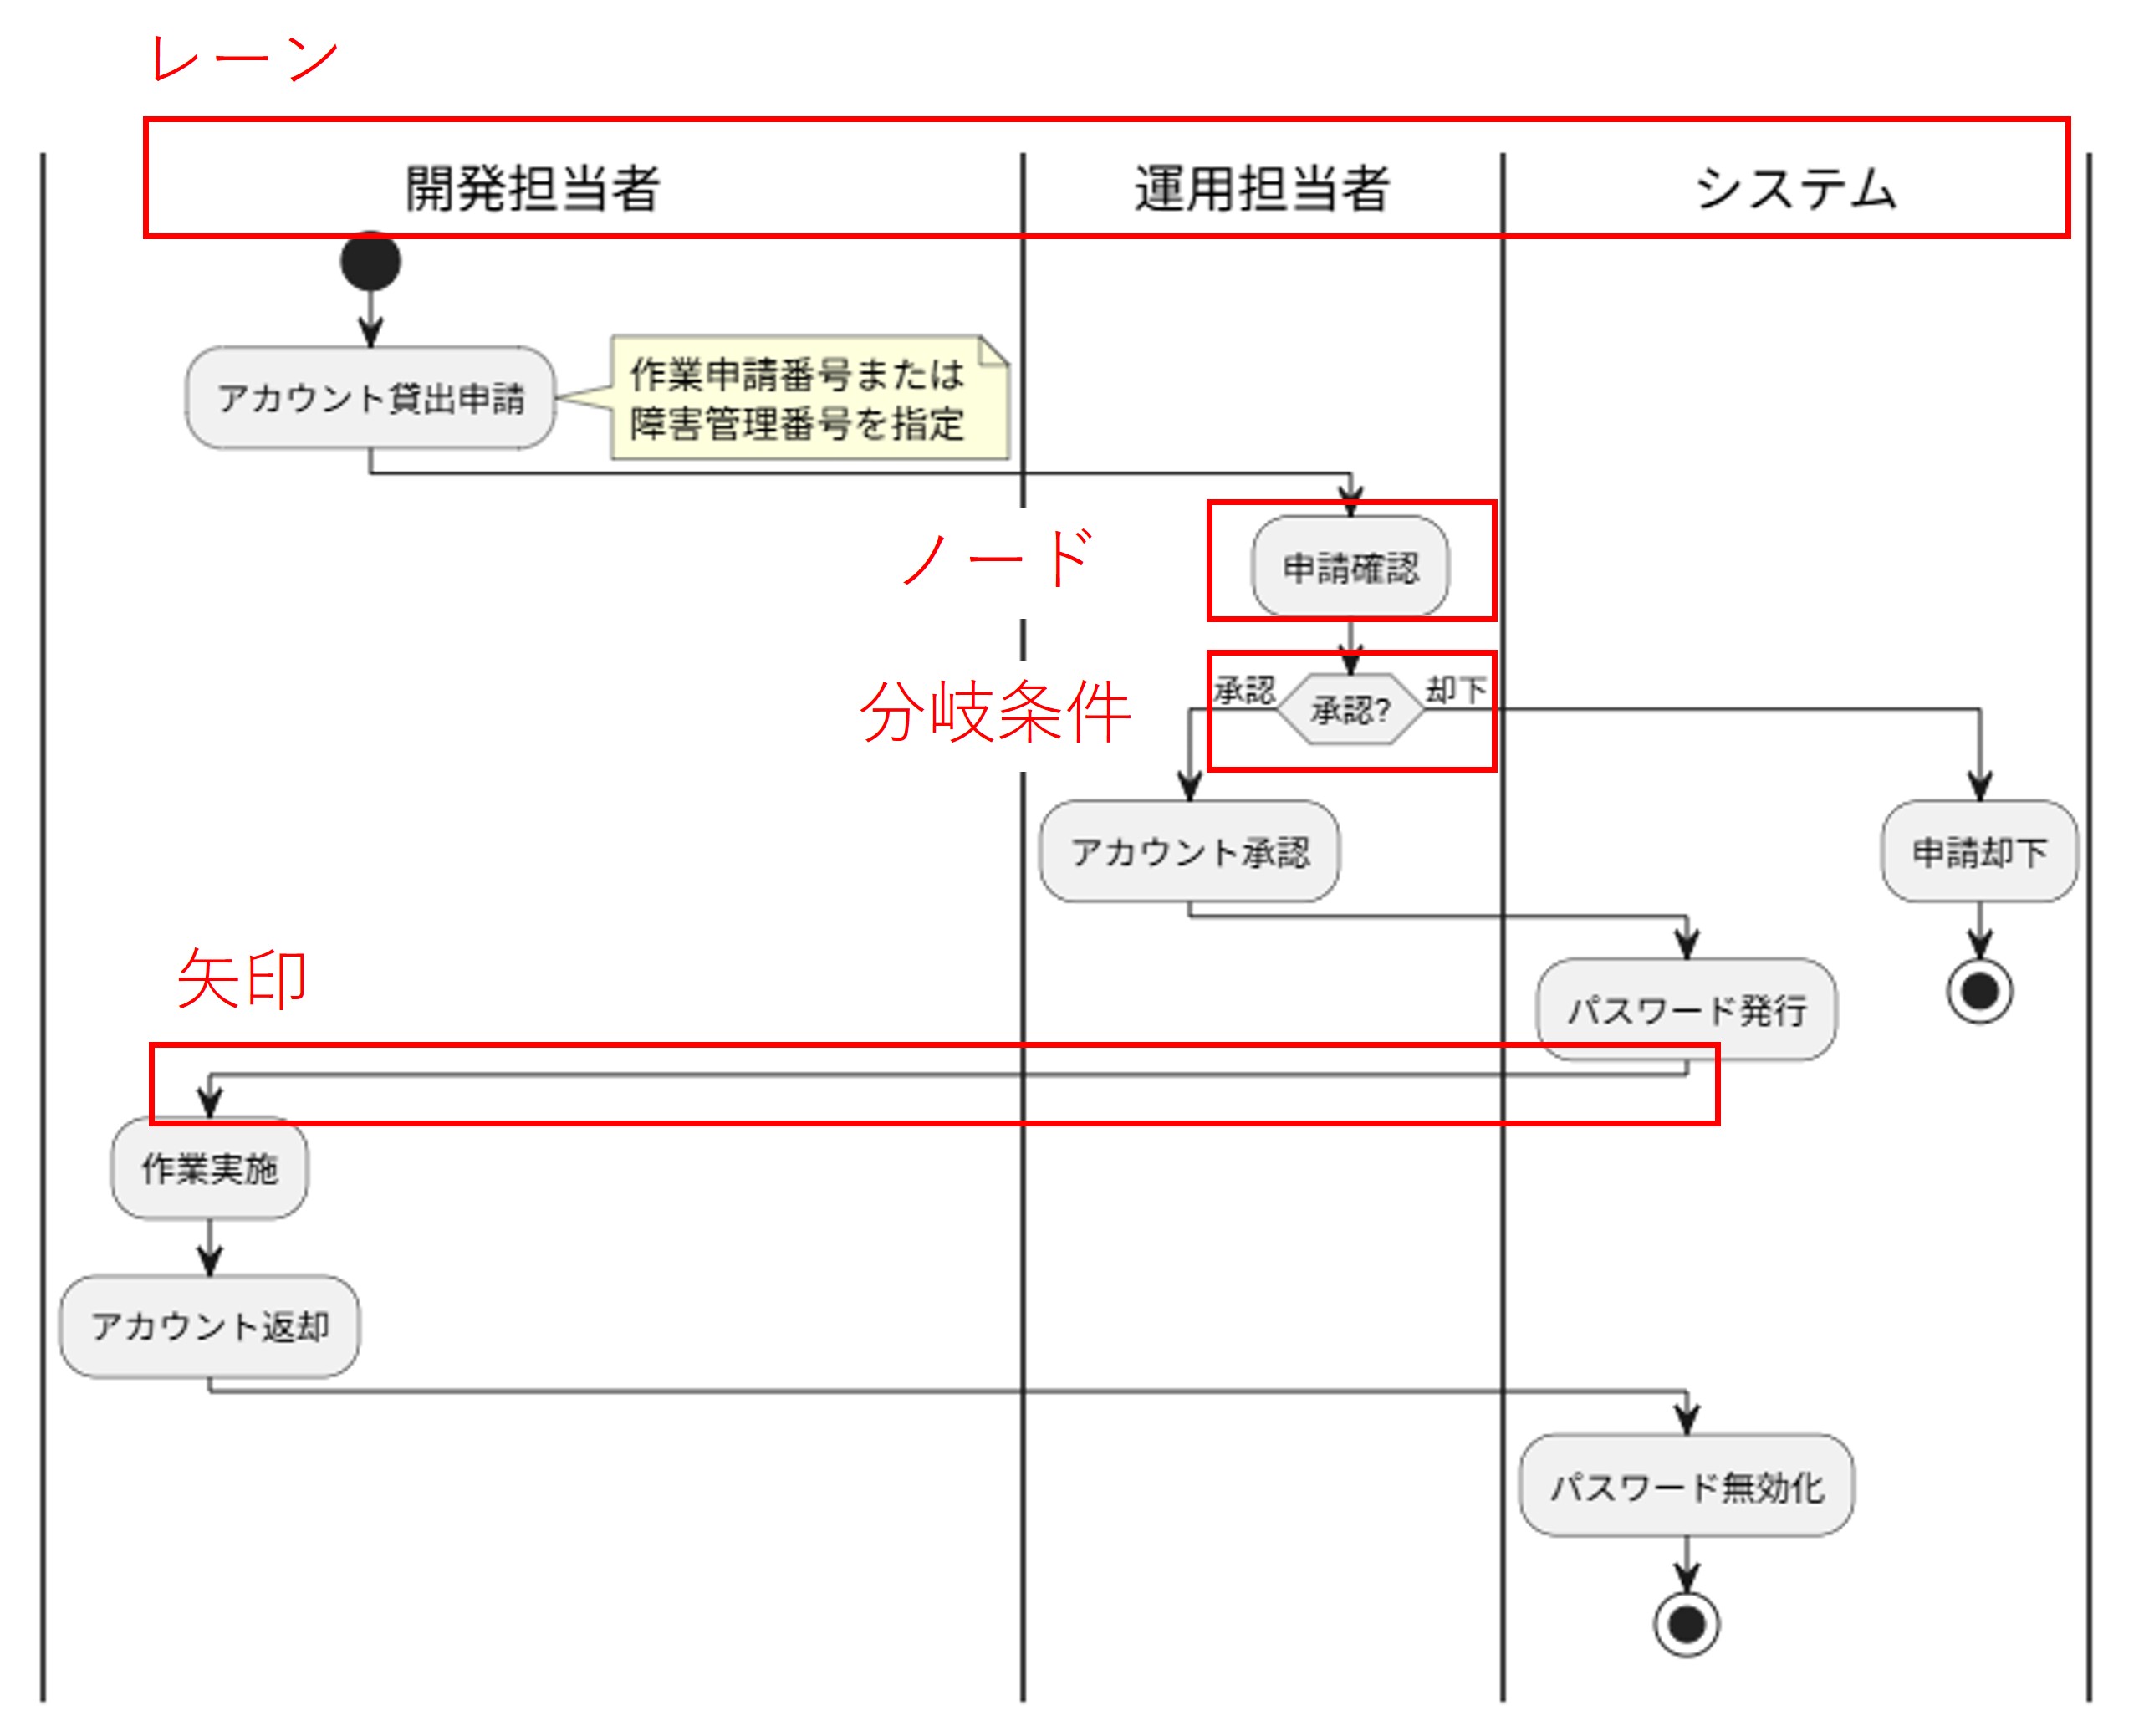
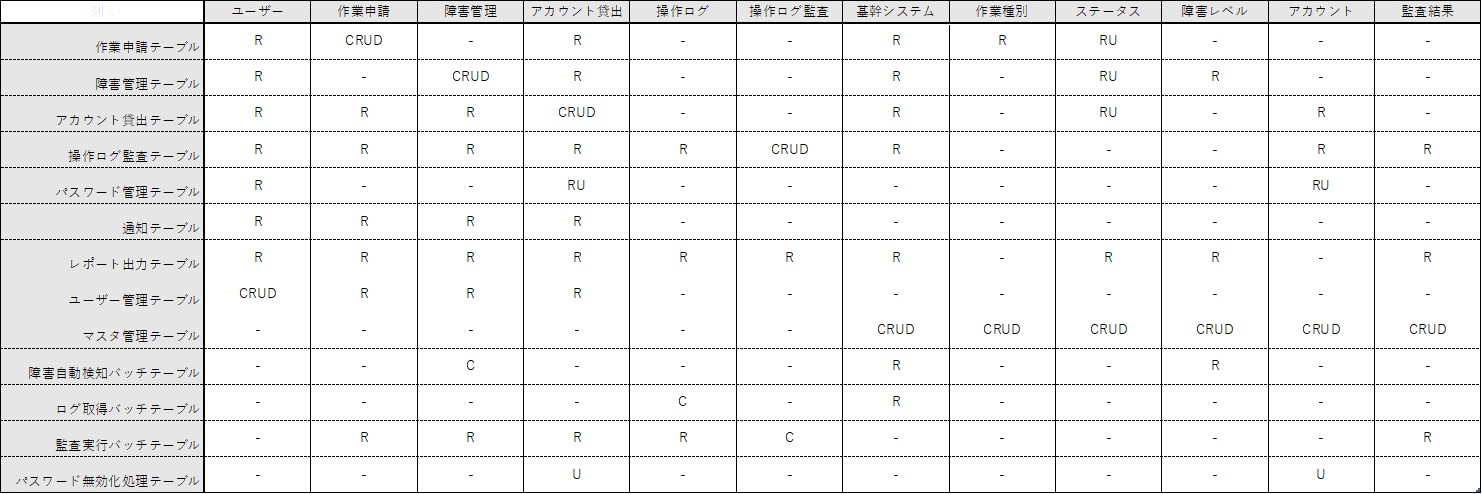
本検証用に構築した「作業申請管理システム」に関する画像形式(PNG)の業務フロー図(図1)とCRUD表(表1)を生成AIに入力した.
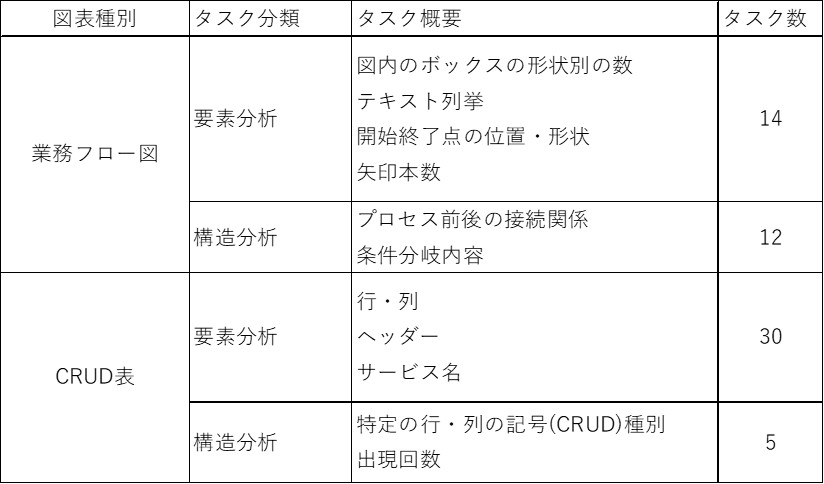
表3に示すように,プロンプトにおいて,「ノード一覧」「矢印(遷移)一覧」「分岐条件」「レーン(担当)」など,抽出すべき要素をあらかじめ項目として列挙させるよう指定した.CRUD表については,「サービス名」「操作種別」の組合せを列挙させた.
図表ごとに,人手で作成した正解データと生成AIの出力とを突き合わせ,要素単位での一致・不一致および関係性の取り違えを確認する.
3.2 意味理解の観点の評価手順
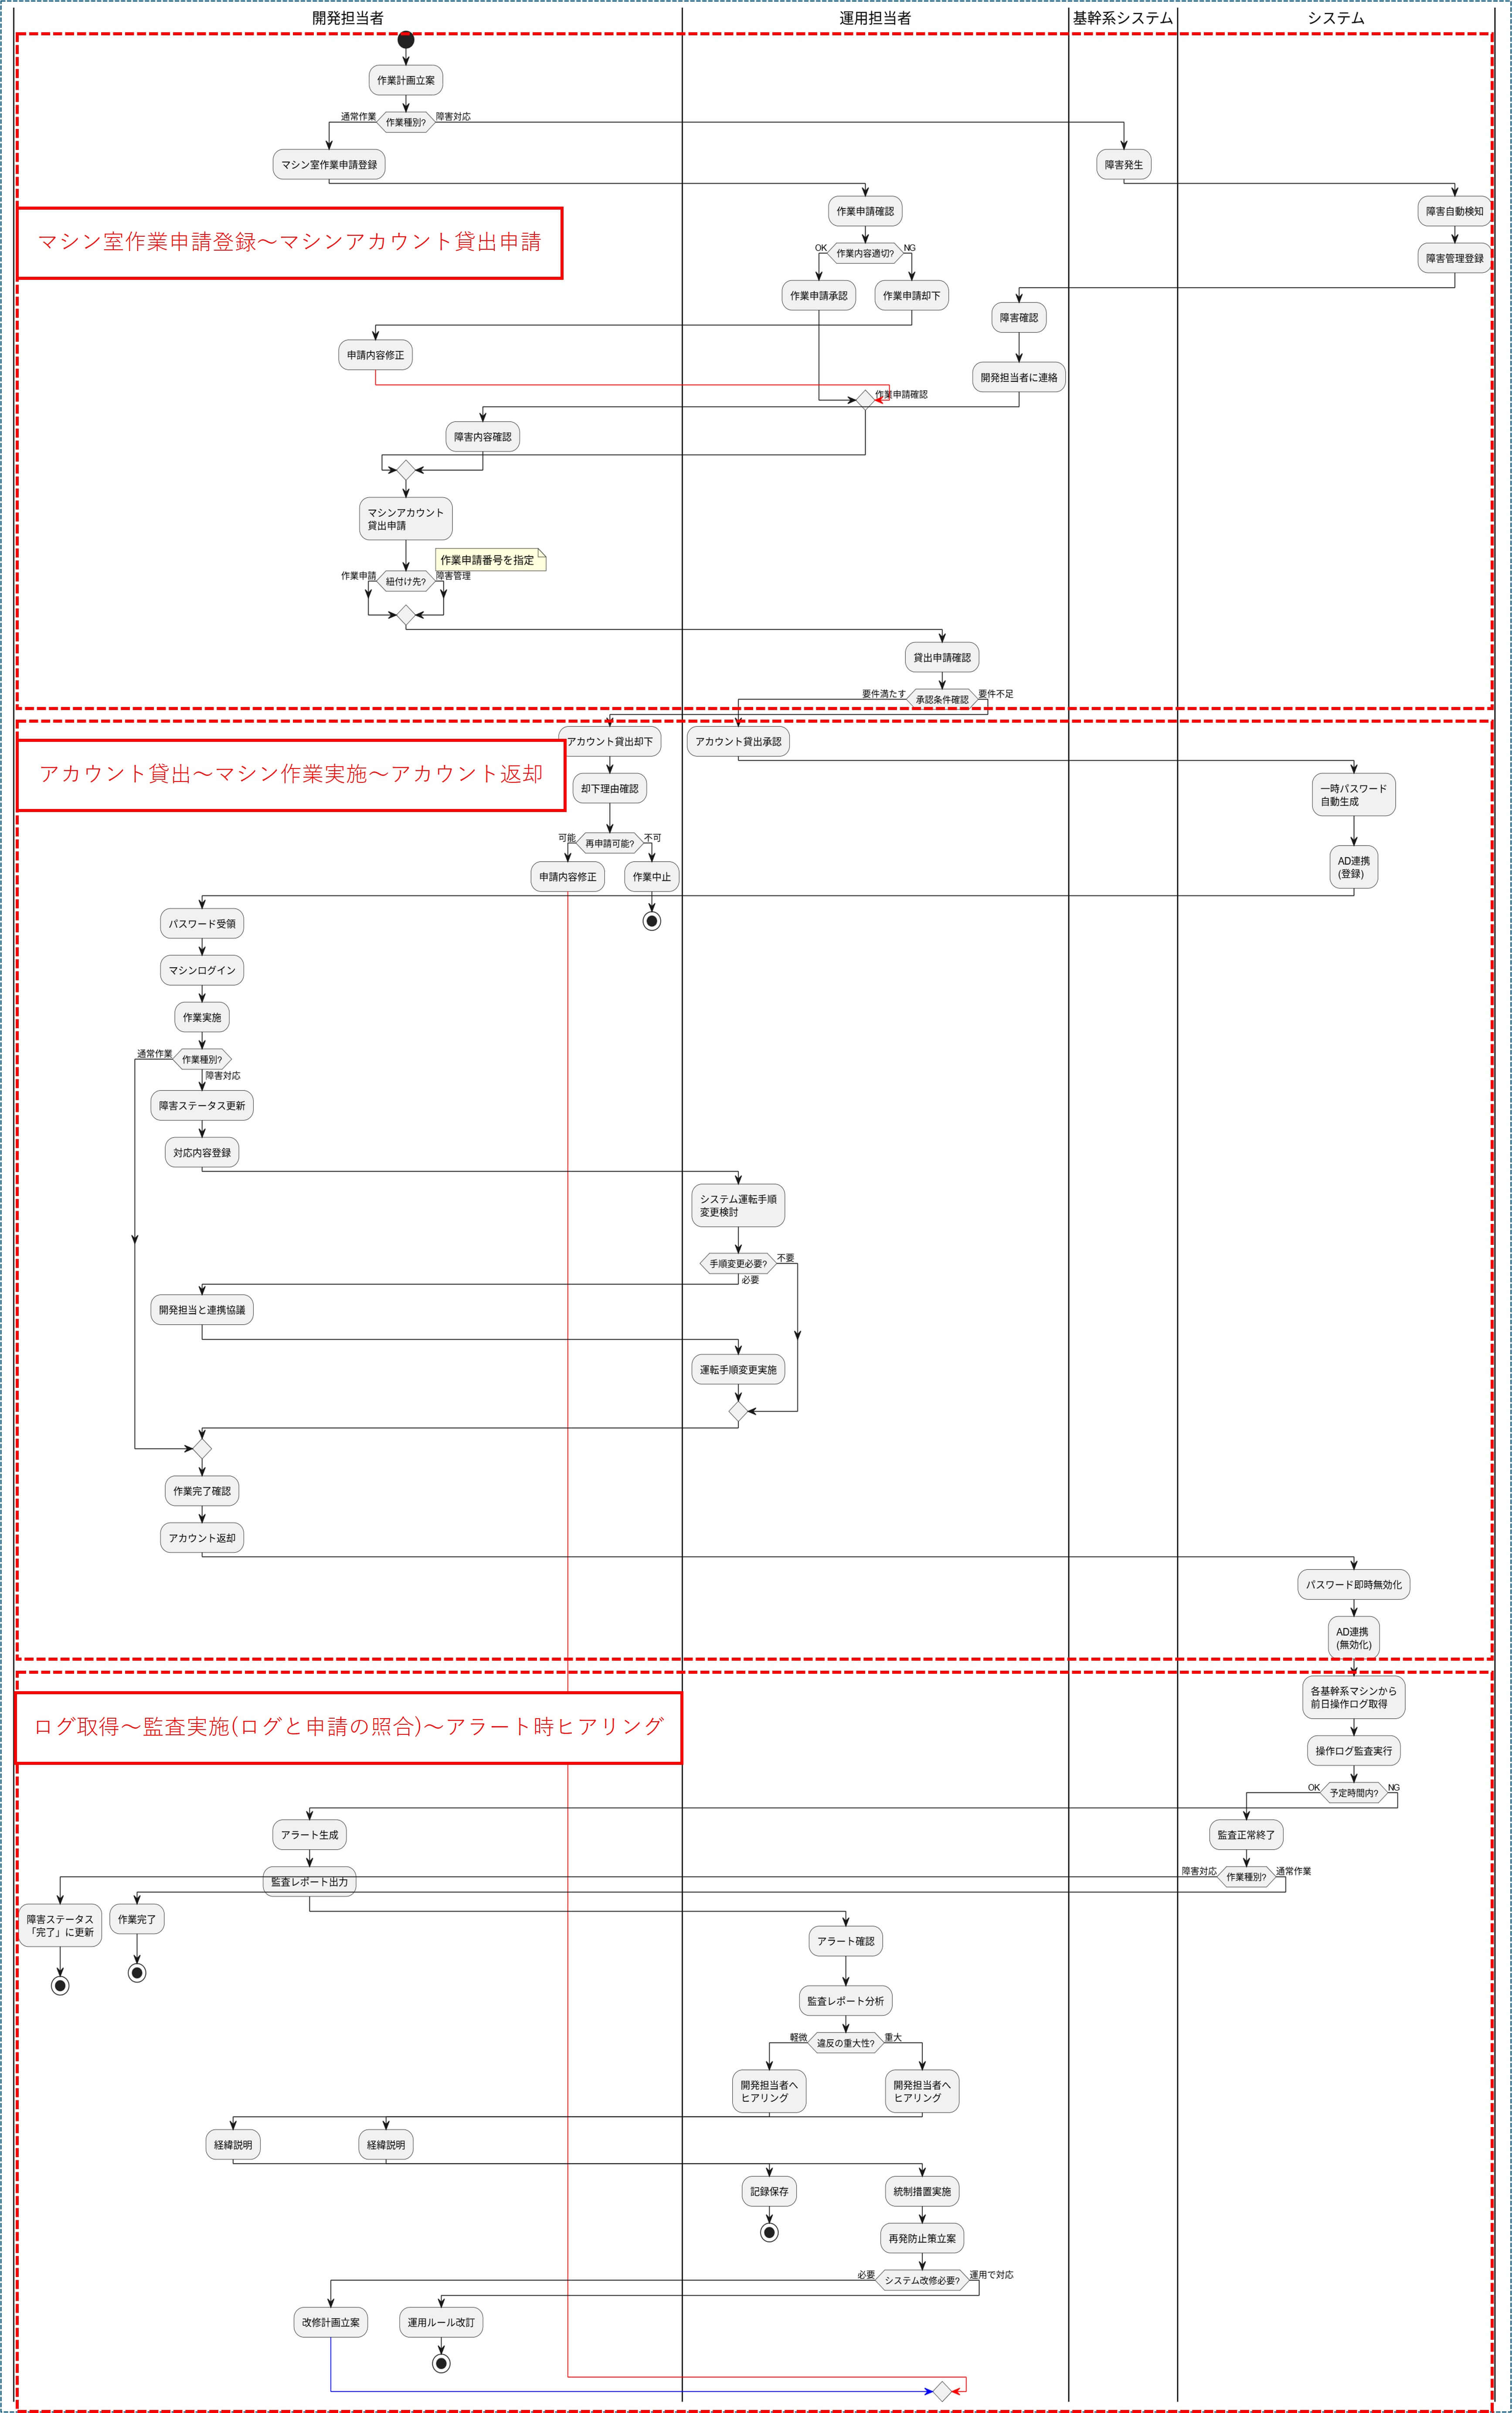
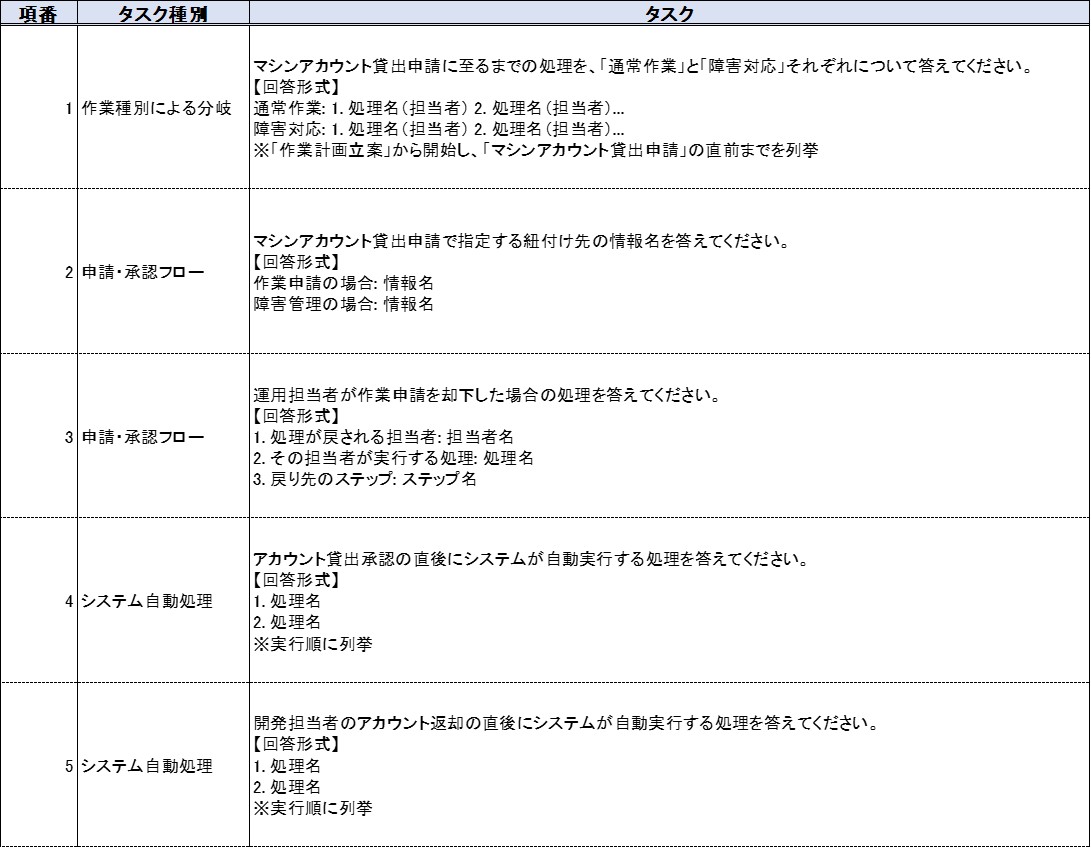
意味理解の観点では,構造理解を前提として,業務ロジックやシステム振舞いをどの程度説明できるかを確認する.なお,検証においては,社内でレビュー効率化ニーズの高い図表の1つである業務フロー図を対象として,評価を行うこととした.構造理解の観点の評価においては,部分的な切り出しのみにとどまるため,図2に示す本格的な業務フローを設定した.評価手順は以下のとおりである.
- 意味理解の評価用タスクの設定
- プロンプト設計の段階的改良
- 人手による評価
「マシンアカウント貸出申請に至るまでの処理を,通常作業と障害対応それぞれについて答えよ」といった業務フロー図で定義された業務・処理の順序性・発生条件等を理解しているかを観点として表3に示すタスクを設定した.
初期状態では,構造理解と意味理解を一度に要求する素朴なプロンプトを用い,その結果の妥当性を確認する.その後,プロンプトを改良し,意味理解の精度への影響を確認した.
生成AIから出力された説明文について,「業務フローの意図を適切に表現できているか」という観点から評価した.
この過程では,画像ベースでの検証を通じて,意味理解が不十分な場合に,生成AI固有の限界によるものか,プロンプト設計の工夫により改善可能かを切り分けることを意図した.
3.3 レビュー支援の観点の評価手順
設計書レビュー全体としては,業務要件との整合性・網羅性・処理ロジックの妥当性評価などさまざまであり,観点ごとにレビュー時の難易度の違いが存在するが,はじめからそれらを網羅的に自動化の対象とするのは現実的ではない.まずは,用語・ID・分岐ラベル・レーン構造といった,ルールを明示しやすく機械的な確認も行いやすいチェックから検証を進めることで,「どの程度まで生成AIに委譲できるか」を段階的に見極める必要がある.この方針に従いFukuda et al., 2025 [5,6]の整理を活用する.レビューの観点を11種類に分類し,それぞれについて,非専門家向け難易度(Level 1/2),専門家向け難易度(Level 3/4),単一設計書か複数設計書かといった軸で整理したものであり,その中でConsistency Check(整合性チェック)は「設計書間で内容が一貫しているかどうか」を確認する観点として定義されている.このうち,単一設計書内の整合性チェックの観点についてはNon-Expert Level 1に位置づけられており,本研究では本観点を対象とした.
本研究では単一の業務フロー図を対象とした単一設計書内の整合性チェック(Non-Expert Level 1)に範囲を限定しつつ,以下2層の潜在バグを意図的に混入させて設定し,段階的プロンプトを用いた生成AIが,これらの潜在バグをどの程度までレビュー指摘として抽出できるかを評価する.
- レーンの有無や分岐ラベルの欠落・重複など比較的容易な潜在バグ
- 業務フローの意味理解を要するやや高難度の潜在バグ
レビュー支援の観点では,実際の設計レビューで想定されるタスクを簡略化した上で,モデルがどの程度,懸念点やバグ候補を指摘できるかを確認した.本研究では,業務フロー図を対象とした整合性チェックタスクを中心に評価した.評価手順は以下のとおりである.
- バグ埋め込み図表の作成
- 生成AIによるレビュー指摘結果の評価
正常な業務フロー図(図2参照)をベースとし,レーンの有無や分岐ラベルの欠落・重複など比較的容易な潜在バグと,個々のプロセスやループバックの意味づけなど,業務フローの意味理解を要するやや高難度の潜在バグを複数埋め込んだ「バグ入りフロー図」を各1種ずつ作成した.同一内容について,画像としてのフロー図と,Mermaidによるテキストベースのフロー定義の双方を用意した.
生成AIに対して,整合性チェック専用のプロンプトにより,レビュー指摘を生成した.画像入力とMermaid入力で同一のタスクを実行し,入力形式による違いを比較した.
本研究ではケース数が限られるため,数値化は補助的な位置づけとし,どのような種類のバグに対して検出が得意・不得意か,また画像入力とMermaid入力のいずれを用いたときにレビュー支援として有用な出力が得られやすいか,といった傾向を定性的に整理した.
以上の3つの評価手順により,構造理解→意味理解→レビュー支援へと段階的に生成AIの挙動を確認し,図表を多用する既存の設計書に対して,どの範囲で生成AIをレビュー支援に活用し得るかを検討した.
4.評価結果
本章では,第2章で示した3つの観点──構造理解の観点,意味理解の観点,レビュー支援の観点──および第3章で述べた手順に基づき,評価した結果を整理する.まず4.1節では,CRUD表および業務フロー図を対象として,各モデルが図表の構造をどの程度正しく抽出できているかを確認し,生成AI別の精度比較結果を示す.続いて4.2節では,抽出した構造を前提とした業務フローの説明タスクを通じて,意味理解の観点から性能を評価する.最後に4.3節では,バグ埋め込み済みの業務フロー図を用いた指摘タスクにより,レビュー支援としてどの程度有用な出力が得られるかを検証した結果を述べる.
4.1 構造理解の観点の評価
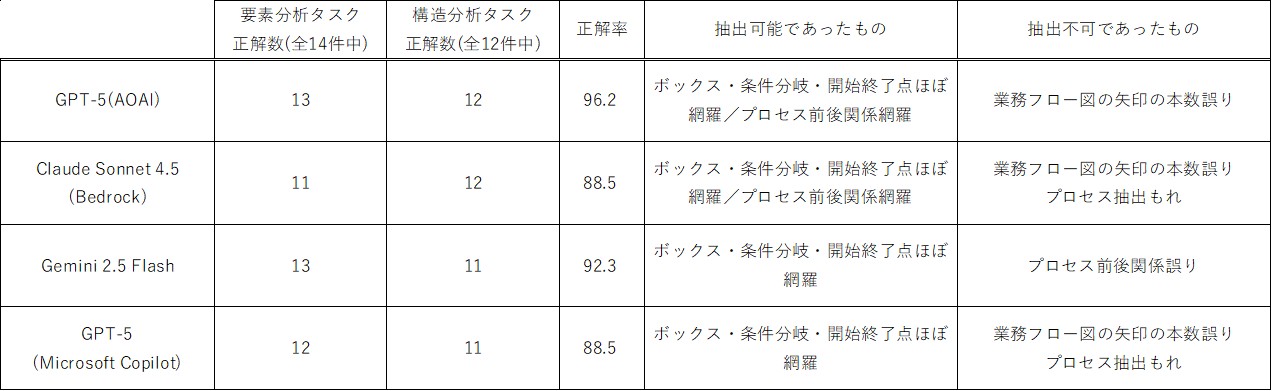
業務フロー図の解析結果を表4に示す.ここでは,業務ステップや分岐・開始・終了ノード等を対象とした要素分析タスク(14項目)と,矢印の本数や接続関係を対象とした構造分析タスク(12項目)の合計26項目について正解数を算出した.いずれのモデルも「ボックス形状別の数」「開始終了点の位置・形状」といった要素レベルの分析では高い正解率を示した.特にGPT-5(AOAI:Azure OpenAI)は,要素分析・構造分析の両方で高い正解数を達成しており,図全体の骨格を把握する点では良好な結果となった.一方で,矢印の本数や接続関係といった細かな構造情報については,複数のモデルで誤りが見られた.典型的には,「分岐後の矢印の本数を1本少なく(あるいは多く)認識する」「矢印の接続先ノードを取り違え,一部のステップ間の接続関係を誤る」といったパターンである.これらの誤りは,業務フローの「大まかな流れ」を把握する上では致命的ではないものの,「この分岐からどのケースがどこに流れていくか」といった詳細なレビューや,設計上の抜け漏れ検知には影響し得る点で注意が必要である.
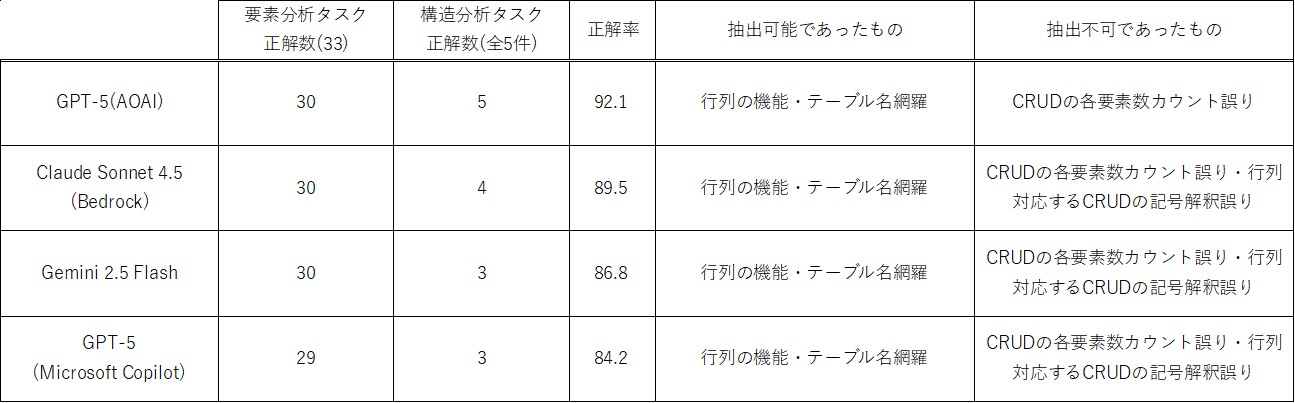
CRUD表(表形式)の解析結果を表5に示す.要素分析タスク(特定のヘッダーとサービス名の抽出33個)および構造分析タスク(CRUD記号の解釈5個)の合計38に対する正解率は,GPT-5(AOAI:Azure OpenAI)が92.1%と最も高く,Claude Sonnet 4.5(Bedrock),Gemini 2.5 Flash,GPT-5(Microsoft Copilot)がこれに続いた.いずれのモデルも,「どのサービス名がどの操作権限(C/R/U/D)を持っているか」という行列構造そのものについてはほぼ完全に網羅できており,行列としての枠組みは正しく理解できていることが分かる.一方で,複数のモデルに共通して以下の傾向が見られた.
- CRUD記号のついたセル数のカウントを誤る
- 行列中の記号(C/R/U/D)の意味を取り違える,あるいは無視する
すなわち,「どのセルに印が付いているか」という視覚的な存在検出はおおむね良好である一方,そのセルが何回出現しているか,各記号をどのように意味付けるかといった,構造上の細部の誤りが確認された.
4.2 意味理解の観点の評価
本節では,業務フロー図に対して設定した20個の意味理解タスク(表3)の結果を,Mermaidによるテキスト入力と,業務フロー図(PNG)画像の入力とで比較する.いずれもGPT-5(AOAI)に対し,第3章で述べたタスク記述どおりのプロンプトを与えた初回実行結果であり,この段階では画像入力に対するプロンプト改良は行っていない.結果は表6に示す.
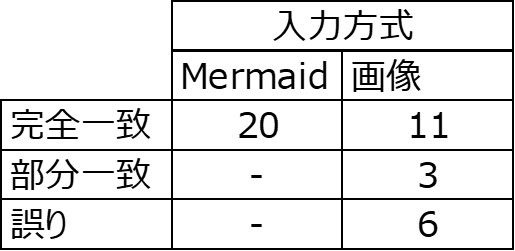
Mermaidによるフロー定義を入力とした場合,20タスク全問が完全一致となった.Mermaidではフロー構造が明示的にテキスト化されていることから,意味理解タスクにおいて安定した性能が得られたといえる.
一方,業務フロー図を画像として入力した場合,20タスクのうち完全一致が11件とおよそ半数にとどまった.おおまかな業務ロジックやシステム処理の流れを問うタスクでは,Mermaid入力時と同等の回答が得られた一方で,障害対応特有の処理や監査(作業後の申請・システムログ照合)フロー,フロー上のループバック表現など,図中の細部まで正確な読み取りを要するタスクで誤りが目立った.画像から得られる構造情報の曖昧さと,一般的なITシステム運用や監査プロセスに関する知識で不足部分を補完しようとする生成過程が誤りの主因となっていると考えられる.
4.2.1 画像入力の場合での改善策
画像入力における意味理解タスクでは,図面に記載された具体的な処理内容よりも,GPT-5(AOAI)が保持する一般的知識で補完され,図2中の障害対応中のステータス更新処理やログ取得・監査のタスクで誤答(×)や部分一致(△)が発生するケースが多かった.Mermaidでは問題なく正解していることから,画像入力においては図の構造理解から意味理解に至る過程の中に問題があると考えられる.そこでGPT-5(AOAI)自身に「業務フロー図からレビュー指摘を導くための推論手順」を説明させ,その内容を整理・一般化する形で7ステップからなる段階的プロンプト(図3)を設計した.
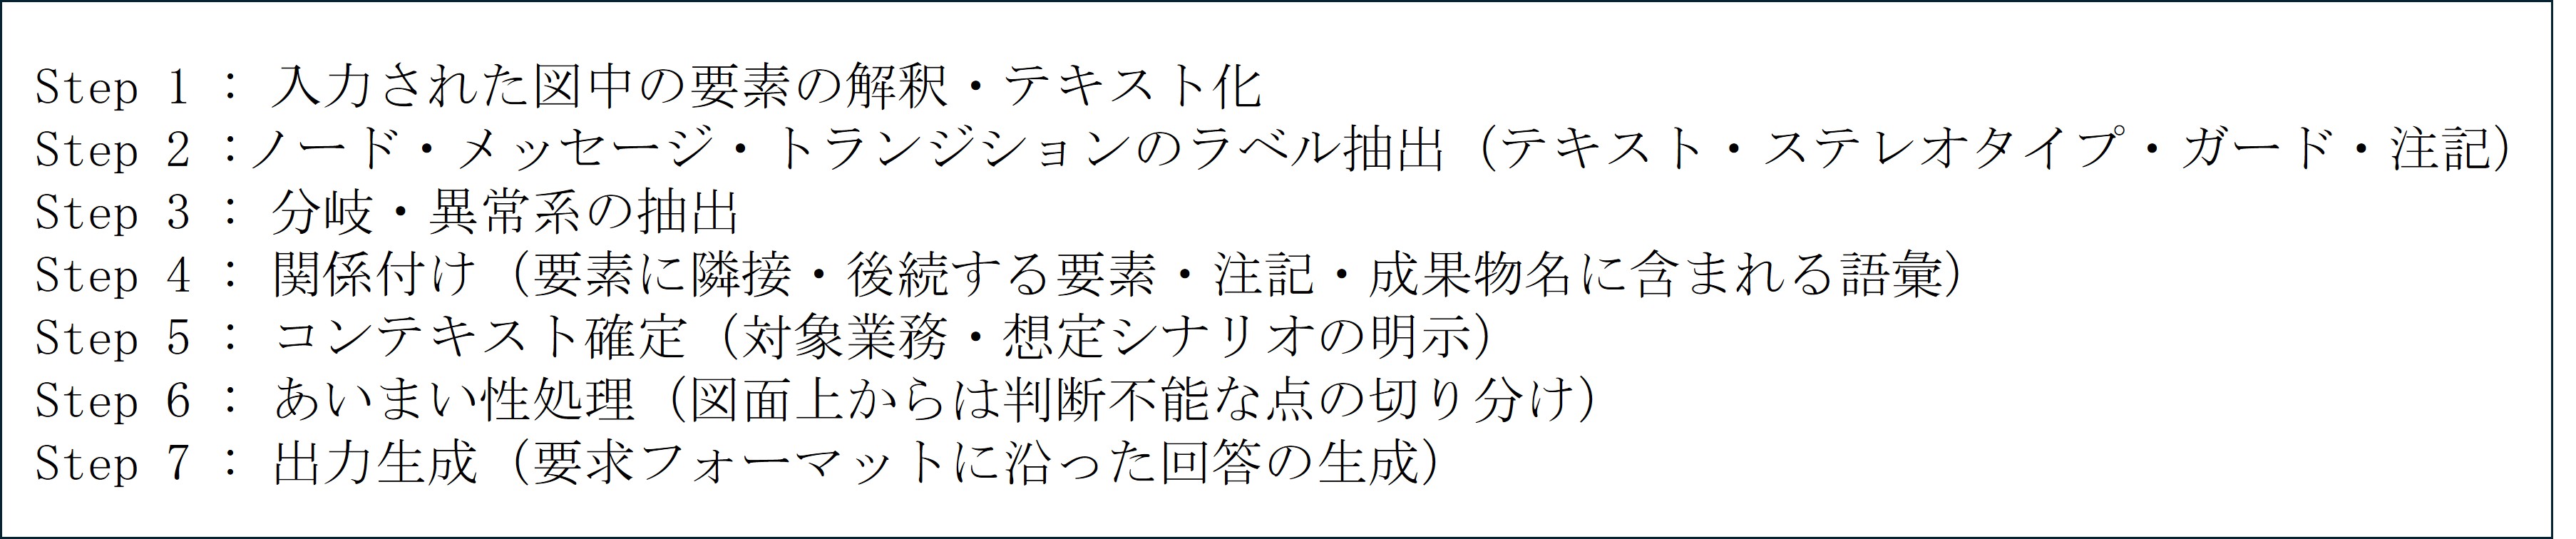
このプロンプトの特徴は,図面からの事実抽出(Step 1-2)と,それに基づく推論(Step 3-6)とを明示的に分離していること,および推論を図面近傍の文脈に制約した上で出力生成を行っていること(Step 4)の2点である.Step 2にてノードやトランジションのラベルを列挙させることで,モデルは一度,画像中のテキスト情報と構造情報を「図面に依拠した中間表現」として外部化する.この段階を経ることで,後続のStep 3–4では,異常系や要素の関連付けを「列挙済みの要素の組合せ」として検討するよう促され,図面外の一般論に基づく判断が抑制できる.さらにStep 5–6を挿入し,「あいまい性処理」を行うことで,「図面からは読み取れないが,一般的にはこうであるはずだ」といった仮定に基づく断定的な回答ではなく,「図面上はここまでが確実であり,それ以外は仮定または不明である」という形で回答を制御しやすくなる.最終的な回答生成はStep 7に集約し,要求フォーマット(列挙形式や分岐ごとの記述形式など)を明示することで,必要な情報が整理された形で出力されるようにした.このプロンプト設計は,複雑なタスクを中間表現の生成と最終判断に分離するChain-of-Thoughtのプロンプティング[4]とも整合的である.
この7ステップを反映した段階的プロンプトを画像入力の意味理解タスク(表3)に適用したところ,20タスク中17タスクで完全一致(〇)となり,誤答(×)・部分一致(△)の件数は大きく減少した.想定どおりの挙動をしていると判断し,以降の評価で画像入力に対しては当プロンプト(段階的プロンプト)を適用する.
4.3 生成AIによるレビュー支援の観点の評価
単一設計書内の整合性チェック(Non-Expert Level 1)の範囲に焦点を絞り,業務フロー図1枚の中に潜在バグを埋め込んで検証を行う.具体的には,機械的に確認可能な整合性を潜在させた「簡単な整合性バグ」パターンの業務フロー図と,フロー全体の意味理解を前提としないと検出が難しい「高度な整合性バグ」パターンの業務フロー図を設定した.これにより,段階的プロンプトを用いた生成AIが,単一設計書内の整合性チェックにおいてどのレベルの潜在バグまで摘出できるのかを評価する.
4.3.1 簡単な整合性バグの摘出結果
レーンの有無やレーン名の一貫性・分岐ラベルの有無・ノード命名の明瞭さといった8観点(全8件)について潜在バグを埋め込んだ業務フローを用意し,業務フローの形式とプロンプトについて2パターンの投入方法にて指摘抽出を試みた.いずれも,潜在バグ数はプロンプト上に設けない方針とした.
- 画像入力(PNG)+段階的プロンプト(図3)+整合性チェック指示のプロンプト
- Mermaid入力+整合性チェック指示のプロンプト
画像入力では8件中6件の潜在バグを摘出した.このほか,改善提案14件および誤検知4件となった.Mermaid入力では8件中7件の潜在バグを摘出した.このほか,改善提案1件および誤検知0件となった.摘出した潜在バグは表7に示す.両形式に共通して検出できたのは,以下のような「構造上のパターンとして把握しやすい」不整合である.
- レーンは存在するが処理がまったく定義されていない(空レーン)
- 同一の役割に対して表記ゆれが生じている(運用担当/運用担当者)
- 分岐条件ラベルが欠落している,あるいは両分岐で同一ラベルになっている
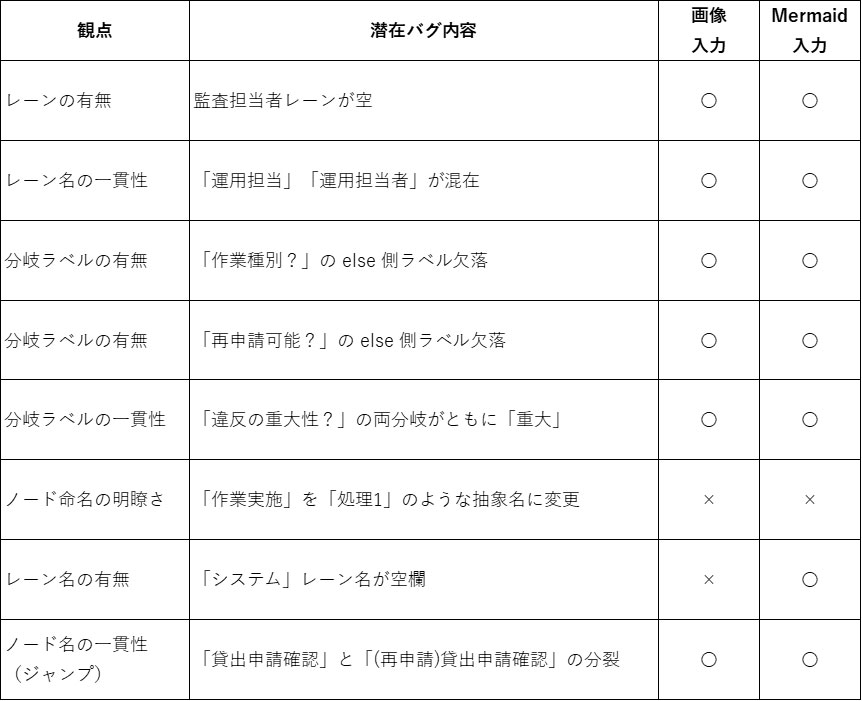
これらは,段階的プロンプトのStep 2でノード・レーン・分岐ラベルを一括抽出し,Step 3–6で「関連付け」や「コンテキスト」を踏まえて「あいまい性」を確認する,という段階的プロンプトの構成と相性が良く,画像入力でも比較的一貫した指摘が得られた.
一方で,ノード命名の明瞭さに関するバグ(「作業実施」を「処理1」のような抽象ラベルに変更するケース)は,画像・Mermaidともに検出できなかった.図面上に「より望ましい具体的名称」が対比として存在しない限り,「抽象的な命名」自体をバグと見なすためには,ドメイン知識や命名規約といった外部基準を前提とする必要があり,本研究で採用した「図面内の情報のみを根拠とするプロンプト」では限界があることが分かる.また,「システム」レーン名の欠落については,Mermaid入力ではレーン定義のテキスト構造から自然に指摘できたのに対し,画像入力ではレーン枠の存在は認識しているものの,ラベル欠落としては指摘に至らなかった.これは,レーン名の有無がテキスト構造として明示されるDSLベースの入力の方が,視覚的なラベル検出に依存する画像入力よりも安定して扱いやすいことを示している.
以上より,簡単な整合性バグについては,段階的プロンプトを用いることで,画像入力はMermaid入力と同等水準の指摘能力が得られるが,レーン枠の有無といった文字ラベルの有無に依存する観点では,DSLベースの構造化表現に優位性があることが確認された.
なお,画像入力とMermaid入力の比較では,前者の方が「改善提案」に分類される指摘が多く生成される傾向が見られた.画像入力の場合,レイアウトや注記などの視覚的手掛かりをもとに,アカウントおよびパスワード払い出し時の媒体(紙・電子データ)や,記録の保存場所・保存方法といった周辺仕様に関する図表記上での追加提案が多く挙がった.一方で,Mermaid入力ではスイムレーンや分岐構造などの構造情報に表現が絞り込まれるため,業務フロー上の分岐条件やループ処理の矛盾といったロジック面の整合性バグに指摘が集中する結果となった.こうした違いは,画像とDSLそれぞれが表現し得る情報の範囲の差異が,そのまま生成AIによる指摘の性質として表れたものと示唆される.
また,画像入力の場合の誤検知については,開始ノードが複数存在することを一律に問題視する指摘や,一部ノードの終端到達が不明であるとする指摘であった.これらは業務フロー図の記述上問題とはならないものの,段階的プロンプトのStep1において一般的なUMLの入力を受付可能とする方針を与えていることにより,当該業務フロー図固有の設計意図と,一般的な図記法上のルールとを部分的に混同してしまった結果と考えられる.
4.3.2 高度な整合性バグの摘出結果
次に,単一設計書内の整合性チェック(Non-Expert Level 1)の範囲にとどまりつつも,業務フローの意味理解や状態遷移の妥当性を前提としないと検出が難しい,やや高度な整合性バグ(表8)を対象として評価を行った.具体的には,開始・終了条件と業務シナリオの整合・障害ステータスの状態遷移・例外フローの帰結など8観点(全8件)について,意図的に業務フローを崩す形でバグを埋め込み,画像入力(PNG+段階的プロンプト)およびMermaid入力の双方で指摘抽出を試みた.
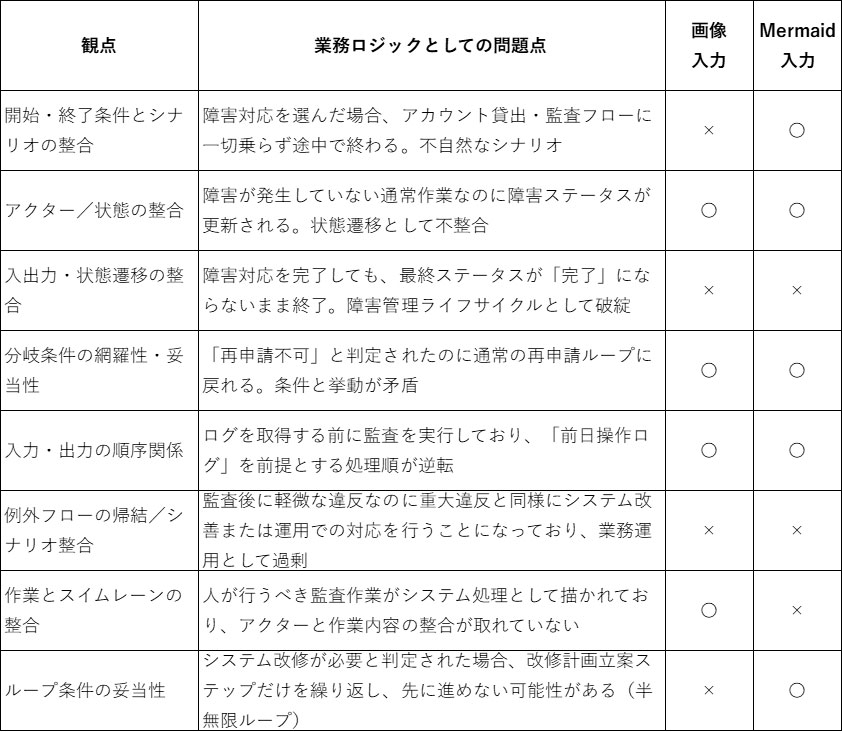
この8観点について,画像入力では4件の潜在バグを摘出した.このほか,改善提案11件および誤検知4件となった.Mermaid入力では5件の潜在バグを摘出した.このほか,潜在バグに起因し後続のフローで矛盾が発生したことでの追加の指摘10件を摘出した.4.3.1項で扱った比較的容易な整合性バグ(画像 6/8,Mermaid 7/8)と比べると,いずれも検出率は低下しており,「業務フローのシナリオや状態遷移の妥当性」を問うタスクの難しさが表れている.
- 両形式で検出できたケース(画像・Mermaid ともに〇)
- 両形式で検出できなかったケース(画像・Mermaidともに×)
- 画像とMermaidで結果が分かれたケース
「通常作業側で障害ステータスを更新してしまう」ケースや,「再申請不可にもかかわらず再申請ループに戻す」ケース,「ログ取得と監査の順序を入れ替える」ケースでは,いずれも分岐条件とその結果,あるいは前提条件と後続処理の間に直接的な矛盾 が存在する.この種のバグは,Step 2で抽出したラベルをもとに,Step 3–4で局所的な前後関係を確認するだけで検出しやすく,画像入力・Mermaid入力のどちらでも比較的安定して指摘できた.
「障害対応後も障害ステータスが『完了』にならず終了する」ケースや,「軽微違反でもシステム改善または運用での対応を行う」ケースは,仕様としては不自然であるものの,図面上は「あり得なくはないシナリオ」として読めてしまう余地もある.図中の手続きが一貫している限り「想定外だがバグ」とまでは断定しにくいようであり,業務慣行や運用ポリシーといった前提を共有していないことが,検出の難しさに直結していると考えられる.
「障害対応フローが貸出・監査フローに合流せず途中で終了してしまう」ケースや,「システム改修計画立案が無限ループになる」ケースでは,Mermaid入力でのみバグとして指摘され,画像入力では見逃されている.これらはいずれも,フロー全体の接続関係やループ構造を俯瞰して捉える必要があり,ノード間の接続がテキストとして明示されるDSLベースの表現の方が有利に働いたと推測される.一方,「監査作業がシステムのスイムレーンに移動している」ケースは逆に画像入力のみで指摘されており,ラベルと位置情報から「監査」という語の意味を人手作業と結び付ける推論が働いた可能性がある.
なお,改善提案および誤検知の双方の傾向は4.3.1項と同様であった.
総じて,意味理解を要する整合性バグについては,段階的プロンプトを用いたとしても,分岐条件と結果・処理順序など,局所的な矛盾が明示的に現れるバグは比較的検出しやすい.一方で,業務慣行や運用ポリシーに依存する妥当性は,図面のみを根拠とするプロンプトでは検出しきれないという限界が確認された.また,フロー全体の構造的な歪み(合流の漏れや自己ループ)の検出については,MermaidのようなDSLによる構造化表現の方が相対的に有利であり,「既存の図面をDSLに変換する/新規開発ではDSLを前提とする」といった組合せが重要になることが示唆される.
5.考察
本研究では,既存のOffice文書上に多数含まれる業務フロー図・CRUD表を対象に,生成AIを用いた設計書レビュー支援の可能性を検証した.その結果に基づき,本章では以下4点について考察する.
- 単一設計書内の整合性チェックにおける有効性
- 画像とDSL(Mermaid)の役割の違い
- 段階的プロンプト設計の意義と実務適用上の課題
- 設計実務での生成AIの活用の位置づけ
5.1 単一設計書内の整合性チェックにおける有効性
まず,単一の業務フロー図を対象としたNon-Expert Level 1相当の整合性チェックについては,一定の前提条件のもとで,生成AIをレビュー支援ツールとして実務に組み込むことが現実的であることが示唆された.
特に,MermaidによるDSL表現を入力とした場合,レーン構造・分岐ラベルの欠落・不統一といった「機械的に確認しやすい整合性バグ」8件のうち7件について,埋め込んだ潜在バグを自動的に摘出できた.画像入力の場合でも,段階的プロンプトを適用することで6件でバグを指摘できており,一次スクリーニングとしては,実務上利用可能な水準と評価できる.
一方で,障害ステータスの最終値や例外フローの帰結など,業務ポリシーや運用ルールを前提とする「暗黙的な意味理解を要する整合性バグ」については,画像入力で4件,Mermaid入力で5件と検出率はおおむね50%程度にとどまった.図面上の手続きが形式的には整合している限り,生成AIが「業務運用としては不自然である」という判断に踏み込むことが難しく,単一設計書のみを根拠にレビューを完結させることには限界があると言える.
以上より,本研究の結果は,生成AIにより単一設計書内における構造的な整合性チェック相当までは自動化し,人間レビュアの負荷を軽減するという観点では,有望な結果が得られたと解釈できる.
5.2 画像とDSL(Mermaid)の役割の違い
4.2節意味理解の観点の評価結果から画像入力とDSL(Mermaid)入力が担うべき役割の違いも明らかになった.Mermaid入力時には処理の前後関係は完全に復元できたのに対し,画像入力では一部に誤りが生じていた.レビュー支援タスクにおいても,フロー全体の接続構造やループ関係を問うバグ(障害対応フローの合流忘れや無限ループの追加など)は,Mermaid入力でのみ安定して検出できたケースが多い.これは,DSLによる表現では,フロー構造がテキストとして明示的にモデルへ渡される一方,画像入力では,線分・矢印・ラベルを視覚的に認識した上で内部表現へ変換する追加段階が存在することからトポロジ情報(矢印の接続先,ループ構造,全体の合流関係)の再現の過程の中での誤りが一定程度残るものと推察される.
他方,アクターと作業内容の対応関係のように,ラベルと視覚的な配置から意味を推定するタスクでは,画像入力が優位に働く場面も確認された.監査作業のスイムレーンをシステム側へ移動させたバグについては,画像入力の方が自然に誤りとして指摘できたのに対し,テキスト化されたMermaid入力では,ラベル間の関係を「人が行う作業か否か」という観点で判断しにくかった.
このように,DSL入力は構造的な整合性チェックに優れ,画像入力はアクターと作業の対応など視覚的な手がかりを用いた解釈に一定の強みを持つ.設計書レビュー支援においては,既存資産としてのOffice図表に対してはマルチモーダル入力を活かしつつ,新規開発や将来の再利用を見据えた設計では,MermaidなどのDSLによる図表記述への移行を進めることで,双方の利点を組み合わせる設計方針が望ましいと考えられる.
5.3 段階的プロンプト設計の意義と実務適用上の課題
当初,図面の細部が正確に読み取れていないことに加え,モデルが一般的なITシステム運用や監査プロセスに関する知識で不足部分を補完してしまうことにより,「図面上の仕様」から乖離した回答が生成されるケースが目立った.これに対し,モデル自身に推論手順を説明させる形で7ステップからなる段階的プロンプトを設計した.これにより,意味理解タスクにおける完全正解数は20問中11問から17問へと大きく改善した.これは,図面からの事実抽出とその上での推論を分離し,図面に基づく中間表現(要素列挙)にモデルの注意を固定した上で,局所的な前後関係や分岐条件の矛盾を確認させる構成が有効に機能したと解釈できる.
一方で,本研究で設計した段階的プロンプトは,業務フロー図という特定の図種を対象としたものであり,実際の開発現場におけるシステム設計全般への適用においては,以下3点が今後の検証課題となる.
- どの粒度(図種・機能単位など)で段階的プロンプト設計を行うのが妥当か
- 図種に依存しない共通部分(共通プロンプト)と,個々の図に最適化された部分(個別プロンプト)の境界をどこに引くべきか
- 段階的プロンプトの管理をどのように行うべきか
5.4 設計実務での生成AIの活用の位置づけ
最後に,実務での適用を念頭に,生成AIの活用の位置づけを整理する.本研究の結果からは,生成AIに委譲しやすい範囲は図面内の構造情報とラベル情報だけで判定可能な観点として以下のように整理できる.
- レーンの有無・空レーンの検出
- レーン名・役割名の表記揺れ
- 分岐条件ラベルの欠落・重複・不統一
- 同名ノードの分裂や戻り矢印の不整合
これらについては,レビュー開始前の「一次スクリーニング」として自動実行し,人間レビュアへ指摘候補一覧を提示することで,レビュー漏れ防止と工数削減の両立が期待できる.
一方,人間レビュアによる確認を前提とすべき範囲は以下のように整理できる.
- 障害管理や監査プロセスなど,組織固有の運用ルールや規程と整合しているか
- 設計内容が業務遂行上での現実的なコスト感覚に照らして妥当か
- ノード命名が,プロジェクト内の命名規約やドメイン知識に照らして適切か
これらは単一設計書内を前提とした生成AIによるチェックでは完全な自動化が難しく,生成AIが挙げた指摘候補を踏まえつつ,人間が最終判断を行うことが不可欠である.このように単一設計書内レビューにおいては,「整合性チェックのうち機械的に確認可能な部分」を生成AIに委譲し,「業務ロジックや運用ポリシーにかかわる高難度の判断」は人間に残すという役割分担が現実的である.
6.おわりに
本研究では,システム開発案件における設計書レビュー負荷の高まりを背景に,既存設計書資産上の図表(業務フロー図・CRUD表)に対してマルチモーダルLLMを適用し,設計書レビュー支援としてどの程度活用し得るかを検証した.画像入力・DSL入力の両方を対象に,構造理解・意味理解・整合性チェック(レビュー支援)の3段階で評価を行い,その結果は第5章で整理したとおりである.特に,単一設計書内の整合性チェック(Non-Expert Level 1)については,DSL(Mermaid)入力を前提とすることで,構造的な整合性バグを自動的に抽出できることが確認され,一定の前提条件下では実務適用を見込める水準に近づきつつあることを示した.
一方で,業務シナリオ全体の妥当性や,障害管理・監査プロセスのライフサイクルや例外フローの帰結など,業務ポリシーや運用ルールに依存する観点については,単一設計書の図面のみを根拠とする限り,生成AIの判断には依然として限界があることも明らかになった.こうした結果から,生成AIによる設計書レビューは「人間レビューの完全な代替」ではなく,「整合性チェックの一部を自動化し,人間レビュアの視線を高難度の観点に集中させる」ための支援ツールとして位置づけるのが現実的であると考えられる.
今後の課題としては以下3点が挙げられる.
- 上流工程の要件定義書や運用マニュアルなどをレビュー対象に含めた上で,上流・下流間のトレーサビリティおよび複数設計書間の整合性チェックをどこまで自動化できるかを検証すること
- DSL(Mermaid)を前提とした設計書の記述プロセスと,既存Office文書資産の段階的な移行方針を整理すること
- 本研究で得られた段階的プロンプト設計を,他種別の図表(ER図・状態遷移図・シーケンス図等)にどこまで一般化できるかを確認すること
本研究で得られた知見は,設計書レビューの一部を生成AIに肩代わりさせることにより,限られた有識者リソースをより高度な判断に振り向けるための方策の1つである.今後,実案件への適用とフィードバックを通じて,レビュー観点・プロンプト設計・DSL利用方針をブラッシュアップしていくことで,生成AI時代における設計ドキュメントの在り方と,レビュー工程の再設計に向けた検討を前進させたい.
参考文献
- 1)Azure OpenAIの推論モデル,https://learn.microsoft.com/ja-jp/azure/ai-foundry/openai/how-to/reasoning?view=foundry-classic&tabs=csharp%2CGPT-5(2025/11/27アクセス).
- 2)Amazon Web Services ブログ,https://aws.amazon.com/jp/blogs/news/amazon-bedrock-now-supports-japan-cross-region-inference/(2025/11/27アクセス).
- 3)Google Gemini,https://gemini.google.com/app(2025/11/27アクセス).
- 4)Prompt Engineering Guide,https://www.promptingguide.ai/(2025/11/27アクセス).
- 5)Fukuda, T., Nakagawa, T., Miyazaki, K. and Tokumoto, S.: Development of Automated Software Design Document Review Methods Using Large Language Models, Proc. IEEE Int. Conf. on Software Analysis, Evolution and Reengineering (SANER), pp.91-101, DOI: 10.1109/SANER64311.2025.00017 (2025).
- 6)富士通研究所:Fujitsu TECH BLOG,https://blog.fltech.dev/entry/2025/10/20/designreview-ja(2025/11/27アクセス).
松田裕介
y_matsuda@nochu-info.co.jp
2014年,農中情報システムに入社.システム開発に従事.2020年よりAI・データサイエンスに関する研究業務に従事し,2025年から執筆論文のテーマである「生成AIを活用した設計書レビュー」を担当した.
原 弘明
h-hara@nochu-info.co.jp
2018年,農中情報システムに入社.仮想アプリケーションのインフラ構築・保守業務に従事.2025年よりAI・データサイエンスに関する研究業務に従事し,執筆論文のテーマである「生成AIを活用した設計書レビュー」を担当した.
多田憲弘
n-tada@nochu-info.co.jp
2003年,農中情報システムに入社.OA環境の構築・保守業務に従事.2024年よりAI・データサイエンスに関する研究業務に従事し,2025年から執筆論文のテーマである「生成AIを活用した設計書レビュー」を担当した.
採録決定:2026年6月15日
編集担当:長坂健治(キンドリルジャパン(株))